AIのベンチマークテストは人間の仕事の1割しかカバーできていない
AIの性能を測定するベンチマークテストの中には「人間の仕事をどれだけの精度でこなせるか」を測定するものが多く含まれています。ところが、こうしたベンチマークは「一部のタスク」しかカバーしておらず、AIが労働を代行できるという結果が出たとしても、それは労働全体のうちほんのわずかであることを意味する可能性があるという分析結果が公表されました。
A benchmark map of the US economy | Mercor
https://www.mercor.com/research/labor-index/benchmark-map/
AI研究機関のメルコールは、これまで公開されている労働関連のベンチマークのほとんどは「AIにとって実行しやすいタスク」を中心に検証されているため、AIの能力が過大評価されている可能性があると指摘しています。特に、賃金が高い職種は幅広くカバーされる一方、賃金が低い職種はあまりカバーされておらず、労働者数の割合で見ると多くの仕事がベンチマークによって検証されていないままだとのことです。
メルコールはアメリカの労働省が公開する職業分類法「O*NET」を採用し、既存の代表的な29種類のベンチマークがどれほどの職種をカバーしているのかを調査しました。O*NETはアメリカの労働人口を923の職種に分類し、それらの職で一般的に発生する1万8797の「タスク」を網羅するデータベースです。例えば弁護士であれば22件のタスクがあるとされています。そのうち代表的な6つのタスクは以下の通りです。
1.遺言書、証書、特許出願書類、抵当権設定書類、賃貸借契約書、その他の契約書などの法的文書を作成し、起草し、審査する。
2.商取引、請求責任、訴訟の提起、法的権利および義務について、依頼人に助言する。
3.個人や企業のために、法律、判決、規制を解釈する。
4.先例に関する知識を用いて、訴訟の結果として考えられる展開を分析する。
5.刑事訴訟または民事訴訟において、依頼人を弁護したり被告を訴追したりするために証拠を提示する。
6.法律補助員を監督する。
メルコールは29種類のAIベンチマークを選定し、各ベンチマークのテスト項目を既存のタスクに紐付けました。そして、あるタスクに5件以上のテスト項目が紐付けられていたとき、「そのタスクがベンチマークで十分にカバーされている」と扱いました。
その結果、923の職種のうち、タスクの少なくとも一部について5件以上のテスト項目が紐付けられた職種は208にとどまったとのこと。具体例を挙げると、ソフトウェアエンジニアリングや法律、会計といった職種はAIベンチマークで比較的多く扱われていましたが、トラック運転やガスプラント操業といった職種は少数でした。これら少数派の職種は、記事作成時点におけるAIでは扱いにくく、AI研究者がテストを作りにくいためにベンチマークで採用されなかった可能性があるとのことです。
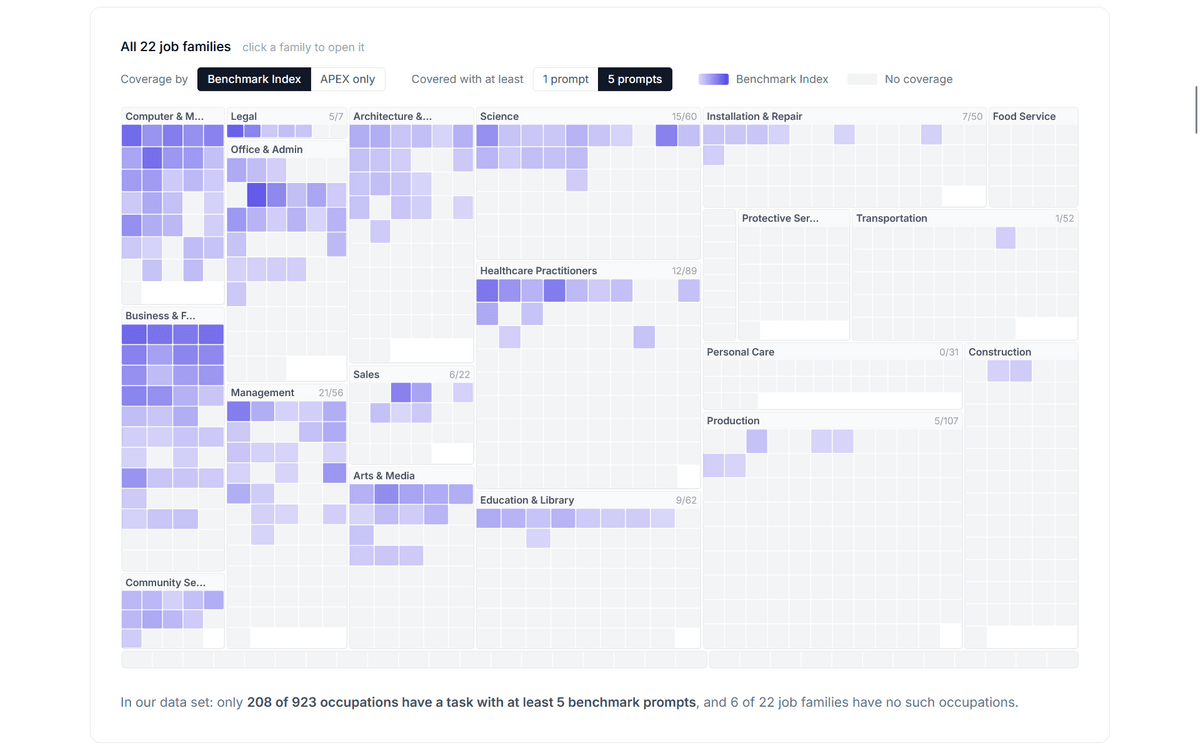
加えて、AIの影響を受ける可能性がある仕事でも、法律秘書や裁判所書記官といった職のタスクは弁護士のタスクに比べてカバーされている割合が低いことも分かりました。
メルコールは「既存のベンチマークがカバーするタスクはタスクの経済規模に左右される」と指摘し、規模が大きい職種ほどAIベンチマークでカバーされやすく、その他の職種はAIベンチマークで見逃されていると論じています。
メルコールによると、アメリカで行われる仕事のうち完全に在宅で実施できるものは37%にすぎず、残り63%の仕事に「ベンチマークに組み込むことが難しい物理世界に関わるタスク」が含まれている可能性があるとのこと。メルコールは、「労働時間という観点で見ると、90%以上の労働が既存のベンチマークでほとんどあるいは全くカバーされていない」と結論づけ、既存のベンチマーク結果だけでは実際の経済に与えるAIの影響を測りきれないと指摘しました。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.