Как мы перестали хардкодить модели: effort-маршрутизация, авто-выбор сложности, фолбэки и лимиты расходов
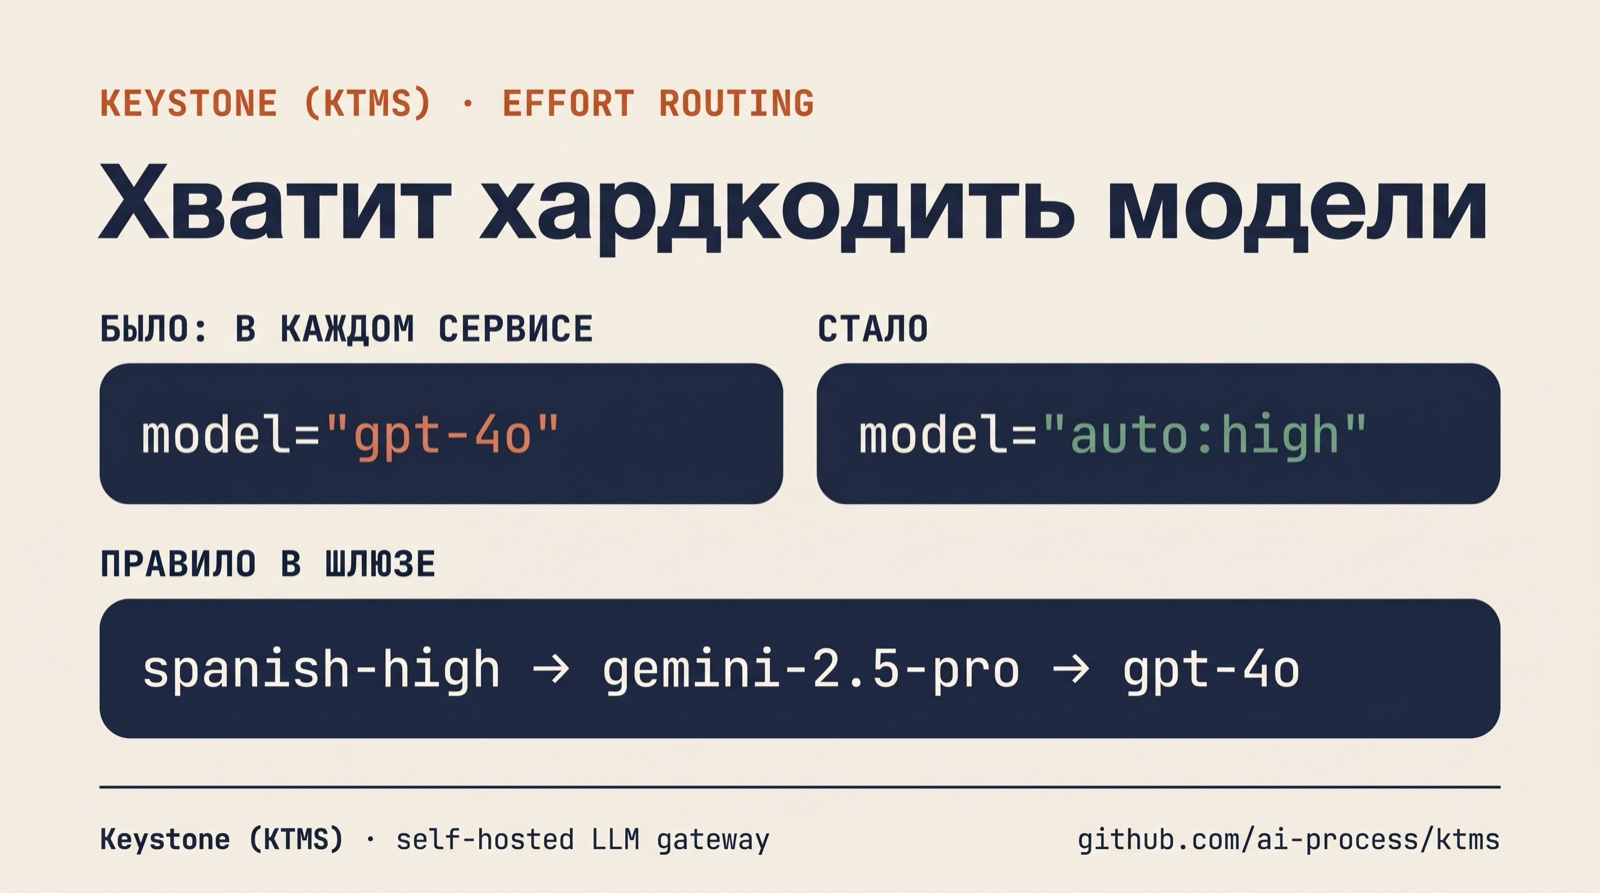
Самая дорогая строчка в микросервисе с LLM — model="gpt-4o". За ней тянутся свой ключ вендора, свои ретраи и счёт, который потом некому разобрать.
Расскажу об одной идее, которая это убирает: сервис не должен знать, какая модель ему отвечает. Вокруг неё четыре механизма: правила маршрутизации, автоматический выбор сложности, поведение при сбоях вендоров и контроль денег. Всё это есть в Keystone. The Model Switchboard. (KTMS), нашем open-source LLM-шлюзе на Go, и примеры кода ниже из него. Но саму схему можно повторить в любом шлюзе.
Проблема: имя модели в сорока местах
Типичная история. Первый сервис, которому понадобилась LLM, получает ключ OpenAI и строчку model="gpt-4o". Через полгода таких сервисов сорок. У каждого свой ключ в своём секрете, своя обёртка ретраев, свой способ считать токены.
Дальше всё ломается предсказуемо:
Вышла модель лучше или дешевле. Сорок pull request'ов, сорок ревью, сорок деплоев. Половина команд обновится через квартал.
Вендор лёг. Падают все сорок сервисов, потому что фолбэк никто не написал, а кто написал, написал по-своему.
Пришёл счёт. Кто потратил деньги, понять нельзя: ключ общий, а метаданных у вызовов нет.
Захотели перевести простые задачи на дешёвую модель. Каждая команда должна сама решить, что у неё «простое».
Корень у всех четырёх проблем один: сервис знает имя модели. А ему нужно знать только, насколько трудна его задача.
Идея: сервис просит сложность, а не модель
В Keystone сервис передаёт effort — LOW, MEDIUM или HIGH — и произвольные атрибуты: язык, тип задачи, пользователя. Шлюз ничего не знает о вашем продукте: атрибуты для него просто ключи и значения, которые сравнивают правила.
conn, err := grpc.NewClient("ktms:9090", grpc.WithTransportCredentials(insecure.NewCredentials()))
if err != nil {
	return err
}
gw := ktmsv1.NewGatewayServiceClient(conn)
ctx = metadata.AppendToOutgoingContext(ctx, "authorization", "Bearer "+apiKey)

resp, err := gw.GenerateText(ctx, &ktmsv1.GenerateTextRequest{
	Effort:     ktmsv1.Effort_EFFORT_HIGH,
	Attributes: map[string]string{"language": "es", "task": "summary", "user_id": "u-42"},
	Messages: []*ktmsv1.ChatMessage{
		{Role: ktmsv1.MessageRole_MESSAGE_ROLE_USER, Text: article},
	},
	MaxOutputTokens: 800,
	ActionId:        "news.summarize",
})
// resp.ResolvedModel, resp.MatchedRule: кто ответил и по какому правилу
Сервис на Python может вообще не знать про gRPC. OpenAI-совместимый HTTP понимает те же правила, а атрибуты берёт из полей самого OpenAI API: metadata становится атрибутами, user — пользователем для лимитов.
from openai import OpenAI

client = OpenAI(base_url="http://ktms:8080/v1", api_key="ktms_...")
reply = client.chat.completions.create(
    model="auto:high",                       # effort закреплён в имени модели
    user="u-42",
    metadata={"language": "es", "task": "summary", "action_id": "news.summarize"},
    messages=[{"role": "user", "content": article}],
    max_tokens=800,
)
Правила: упорядоченный список с фолбэками
Правила живут в Postgres и заменяются целиком одним атомарным вызовом:
grpcurl -plaintext -H "authorization: Bearer $ADMIN_KEY" -d '{"rules":[
  {"name":"spanish-high",  "priority":30, "effort":"EFFORT_HIGH",
   "attributes":{"language":"es"}, "use":["gemini-2.5-pro","gpt-4o"], "enabled":true},
  {"name":"low-default",   "priority":20, "effort":"EFFORT_LOW",
   "use":["deepseek-chat","gpt-4o-mini"], "enabled":true},
  {"name":"anything-else", "priority":1,
   "use":["gpt-4o-mini"], "enabled":true}
]}' localhost:9090 ktms.v1.AdminService/ReplaceRules
Как это работает:
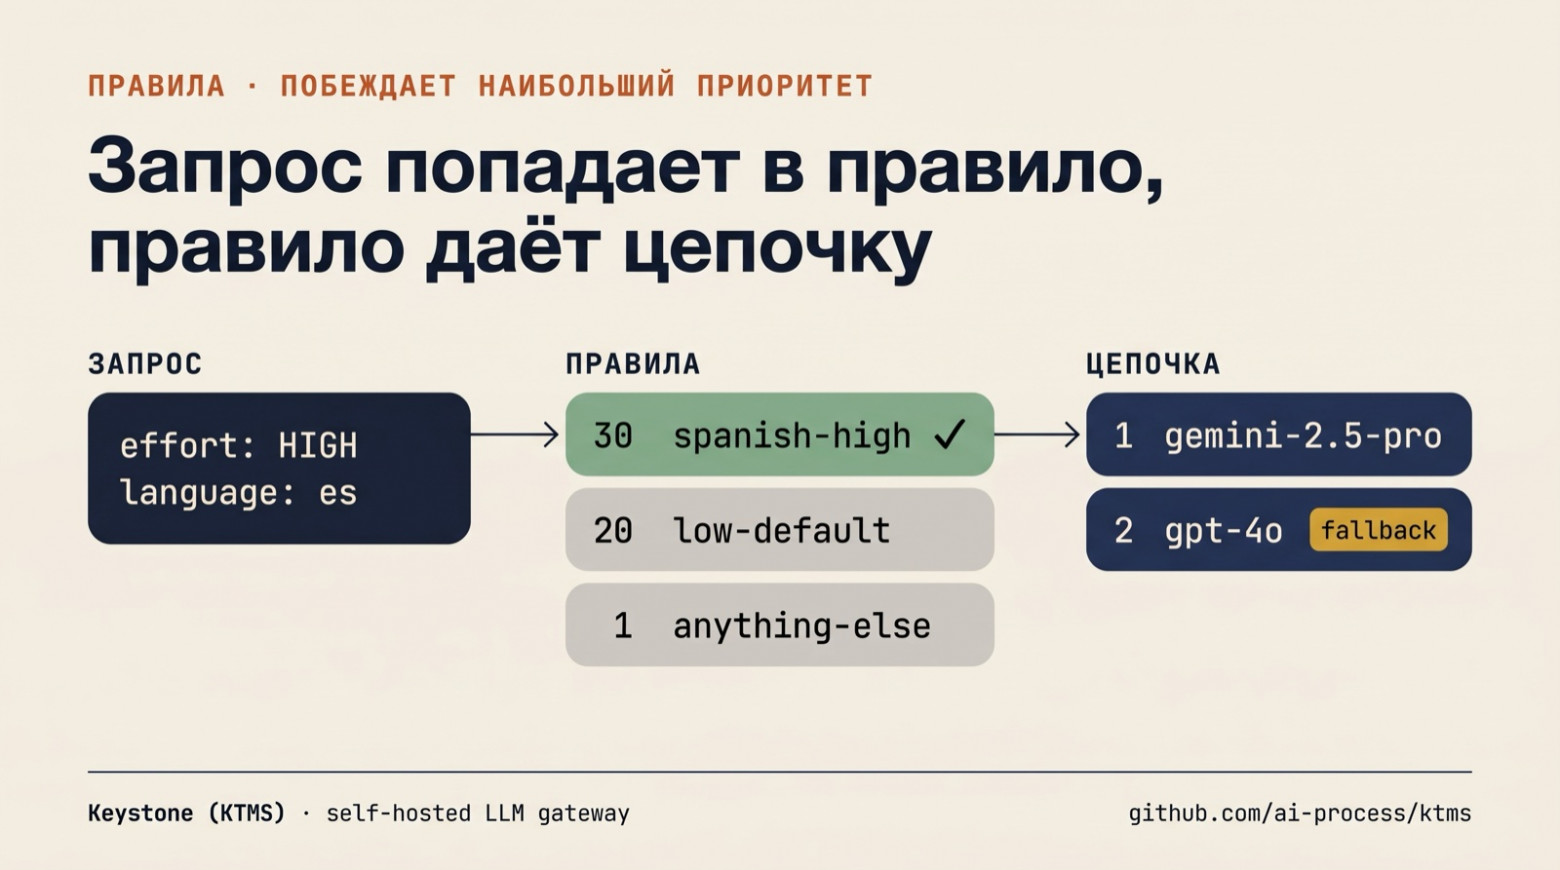
Побеждает подходящее правило с наибольшим приоритетом. Правило подходит, если совпадает effort (не указан — любой) и каждый его атрибут равен атрибуту запроса.
use— это цепочка фолбэков, по соглашению от дешёвой модели к дорогой. Если первая модель недоступна, ограничена или её вендор лежит, пробуется следующая.Валидация не примет набор правил, в котором нет правила без атрибутов для каждого effort. Запрос не может «провалиться» мимо всех правил.
Изменения проверяются в транзакции вместе с текущей конфигурацией, поэтому невалидное состояние не может стать активным. Все реплики подхватывают правила в течение
ROUTING_RELOAD_SECONDS(по умолчанию 60 с), та, что приняла вызов, — сразу.
Куда уйдёт запрос, можно проверить заранее, без вызова модели: ktms route explain billing --effort high --attr language=es покажет правило и цепочку.
Канарейки, A/B и shadow-трафик
Правилу можно дать веса — по одному на модель в use, например [90, 10]. Если в запросе есть user_id или canary_key, распределение детерминированное и «липкое»: один пользователь всегда попадает на одну модель. Так новую модель выкатывают на 10% пользователей без единой строчки в сервисах.
Есть и shadow-маршрутизация: доля трафика асинхронно дублируется на модель-кандидата, не влияя на ответ и задержку основного запроса. Теневые вызовы не списываются с лимитов пользователя, а с shadow_eval судья сравнивает ответы основной и теневой модели и пишет результат в метрики. Это пока экспериментальная функция.
Авто-выбор сложности: судья за 250 мс
Следующий шаг: а что если сервис не знает и сложности? Например, это чат, где пользователь может спросить и «который час», и «объясни разницу между MVCC в Postgres и Oracle».
Для этого есть model: "auto". Шлюз отправляет промпт модели-судье и спрашивает, насколько он сложный. Судья — не чат-модель, а модель решений: она не пишет текст, а возвращает типизированный ответ с вероятностями. Поддерживаются Jev от TypeSafe и OpenAI Decisions. Модели на своих нодах тоже можно отметить как судей (--judge-model у агента ноды) для прямых вызовов Judge.
Правила строгие:
Дедлайн 250 мс. Если судья не настроен, медленный или лежит, запрос уходит с
MEDIUM. Запрос никогда не теряется из-за судьи.Закреплённая сложность всегда побеждает. Сначала effort в имени модели (
auto:low), потом полеreasoning_effort, и только потом судья.Всё видно в ответе. Заголовки
X-KTMS-Route-Mode(auto-judge,auto-default,auto-effort),X-KTMS-Judge-ScoreиX-KTMS-Judge-Model.
curl -si localhost:8080/v1/chat/completions \
  -H "Authorization: Bearer ktms_..." -H "Content-Type: application/json" \
  -d '{"model":"auto","messages":[{"role":"user","content":"Explain MVCC in Postgres vs Oracle"}]}' \
  | grep -i '^x-ktms'
Честная оговорка: выбор сложности судьёй в 1.x помечен как экспериментальный. Он работает и поддерживается, но то, как судья выбирает, может поменяться в минорном релизе. Авто-маршрутизация с закреплённой сложностью (auto:high) стабильна.
Тот же Judge доступен и напрямую, как отдельный API: вы задаёте вопросы о состоянии и получаете вероятности, по которым можно ветвить код, а не текст, который надо парсить.
{
  "state_json": "{\"message\":\"My card was charged twice!\"}",
  "questions": {
    "angry": {"type": "JUDGE_TYPE_NOUL", "instructions": "Is the author upset?"},
    "topic": {"type": "JUDGE_TYPE_CHOICE", "instructions": "What is this about?",
              "options": {"billing": "payments and charges", "bug": "software defects"}}
  }
}
Когда вендор лежит
Фолбэк по цепочке работает, только если шлюз быстро понимает, что модель недоступна. Для этого три механизма.
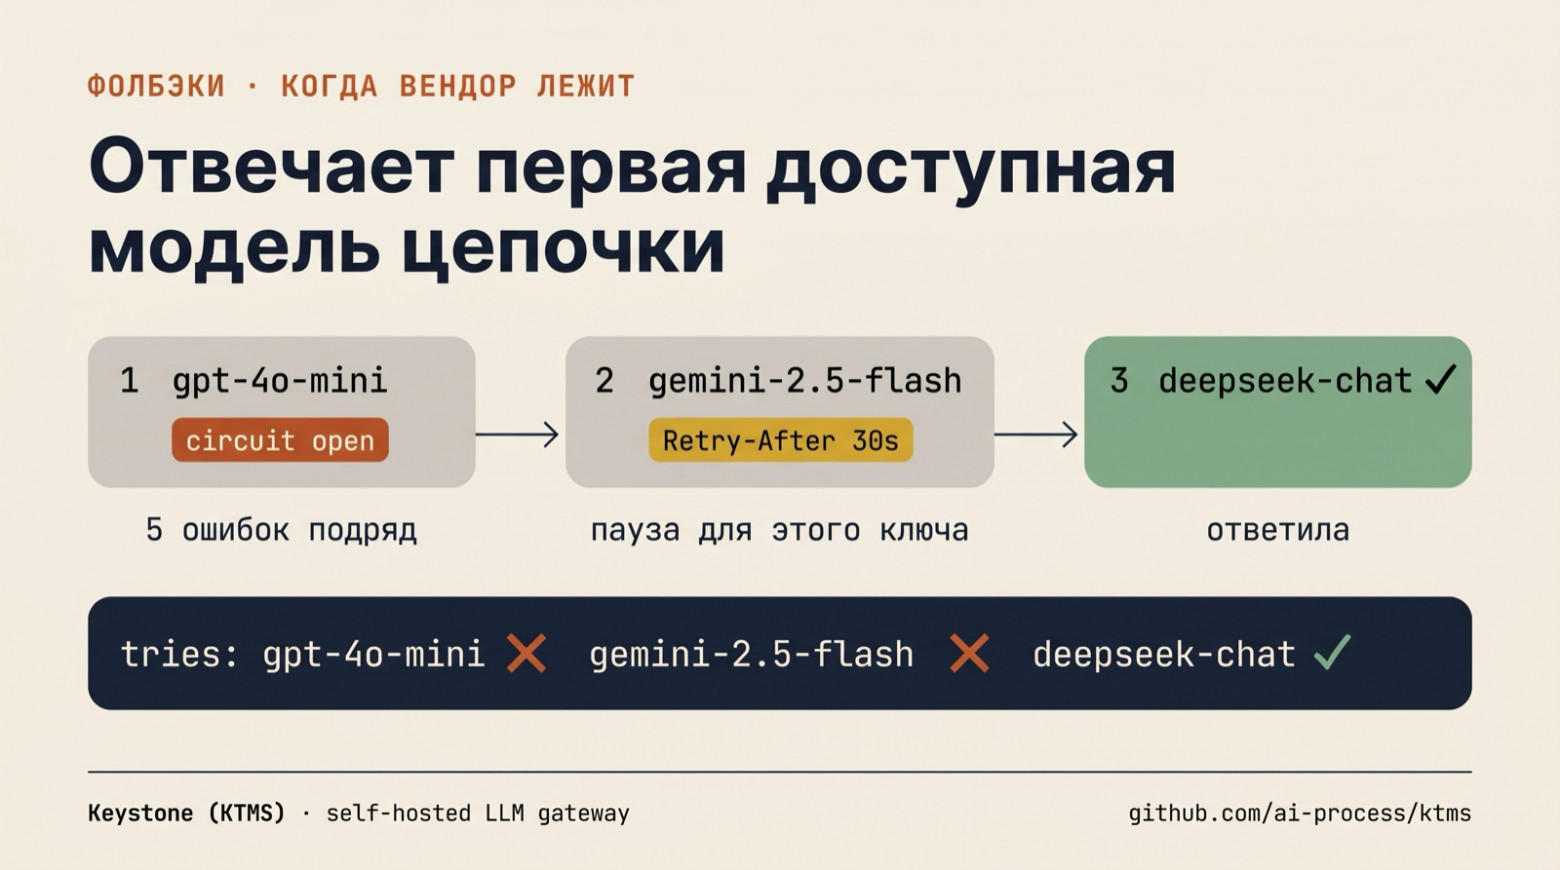
Ретраи под контролем шлюза. Встроенные ретраи SDK вендоров отключены: одна попытка роутера — ровно один вызов вендора. Роутер сам повторяет 429, 5xx или обрыв соединения один раз на той же модели, а потом идёт дальше по цепочке. Для стриминга это работает до первого чанка: после него поток закреплён за моделью.
Circuit breaker на пару (вендор, модель). После 5 подряд неудач (5xx, обрывы, таймауты соединения и UPSTREAM_REQUEST_TIMEOUT) цепь размыкается, и запросы пропускают эту модель вообще без сетевого вызова. Через 30 с один пробный запрос проверяет, ожила ли она. Отмена запроса клиентом цепь не размыкает.
Retry-After как пауза. Если вендор просит подождать, шлюз читает Retry-After, retry-after-ms или google.rpc.RetryInfo у Gemini. Ожидание до 1 с выдерживается на месте. Более долгое ставит модель на паузу для этого ключа вендора (до VENDOR_COOLDOWN_MAX, по умолчанию 5 минут), и цепочка идёт дальше. Клиенты с другими ключами не затронуты. Если на паузе вся цепочка, клиент получает UNAVAILABLE vendors_unavailable с честным Retry-After.
Деньги
Лимиты в долларах
Жёсткие лимиты на ключ и на конечного пользователя за UTC-сутки или месяц, плюс месячный бюджет команды на все её ключи.
# $50 в день для ключа support-bot и $20 в месяц для каждого пользователя по умолчанию
grpcurl -plaintext -H "authorization: Bearer $ADMIN_KEY" -d '{"spend_limit":
  {"subject_type":"key","subject_id":"support-bot","period":"day","limit_nanousd":50000000000}}' \
  localhost:9090 ktms.v1.AdminService/SetSpendLimit
grpcurl -plaintext -H "authorization: Bearer $ADMIN_KEY" -d '{"spend_limit":
  {"subject_type":"user","subject_id":"*","period":"month","limit_nanousd":20000000000}}' \
  localhost:9090 ktms.v1.AdminService/SetSpendLimit
Как это держится под конкурентной нагрузкой:
Перед вызовом каждой модели цепочки шлюз резервирует худший случай: оценка входа × цена входа + максимум токенов × цена выхода. Резерв ставится атомарно на все подходящие счётчики одним Lua-скриптом в Redis.
Когда вызов закончился, резерв пересчитывается в фактическую стоимость.
Вызов, который пересёк бы лимит, отклоняется. При этом более дешёвая модель дальше по цепочке ещё может ответить.
Суммы хранятся в нано-долларах, чтобы не копить ошибку округления.
Клиент получает
RESOURCE_EXHAUSTED throttled:spend_key_daily(или другой конкретный лимит) иRetryInfoдо сброса периода, по HTTP —429 insufficient_quotaиRetry-After.
Отсюда практичный совет: всегда задавайте max_output_tokens. Без него резерв считается по SPEND_DEFAULT_OUTPUT_RESERVE_TOKENS (4096), а неограниченный ответ — самая дорогая ошибка.
Организации и команды
Ключи группируются в организации и команды. У команды есть список разрешённых моделей и месячный бюджет на все её ключи вместе. Модель вне списка — PERMISSION_DENIED, цепочка фильтруется до разрешённых, ListModels показывает команде только её модели. Правила могут сопоставлять org_id и team_id, причём их ставит шлюз по ключу, а не клиент.
Batch за полцены
Для работы, которая может подождать (обогащение каталога, бэкфиллы, ночные пайплайны), есть пакетная генерация через batch API вендоров со скидкой 50%. Маршрут выбирается один раз при отправке: первая модель цепочки с возможностью batch. Отправка идемпотентна по client_batch_id, результаты отдаются по элементам, промпты не сохраняются в базе шлюза.
Что ещё
Лимит запросов в минуту по алгоритму GCRA с настраиваемым burst, суточные бюджеты токенов на ключ и пользователя с допуском 5%, переопределения на пользователя и модель. И одно событие на каждый вызов — в light-tokenmeter или любой gRPC-сервис учёта: вендор, модель, токены, стоимость, правило и ваши атрибуты.
Сколько это стоит по задержке
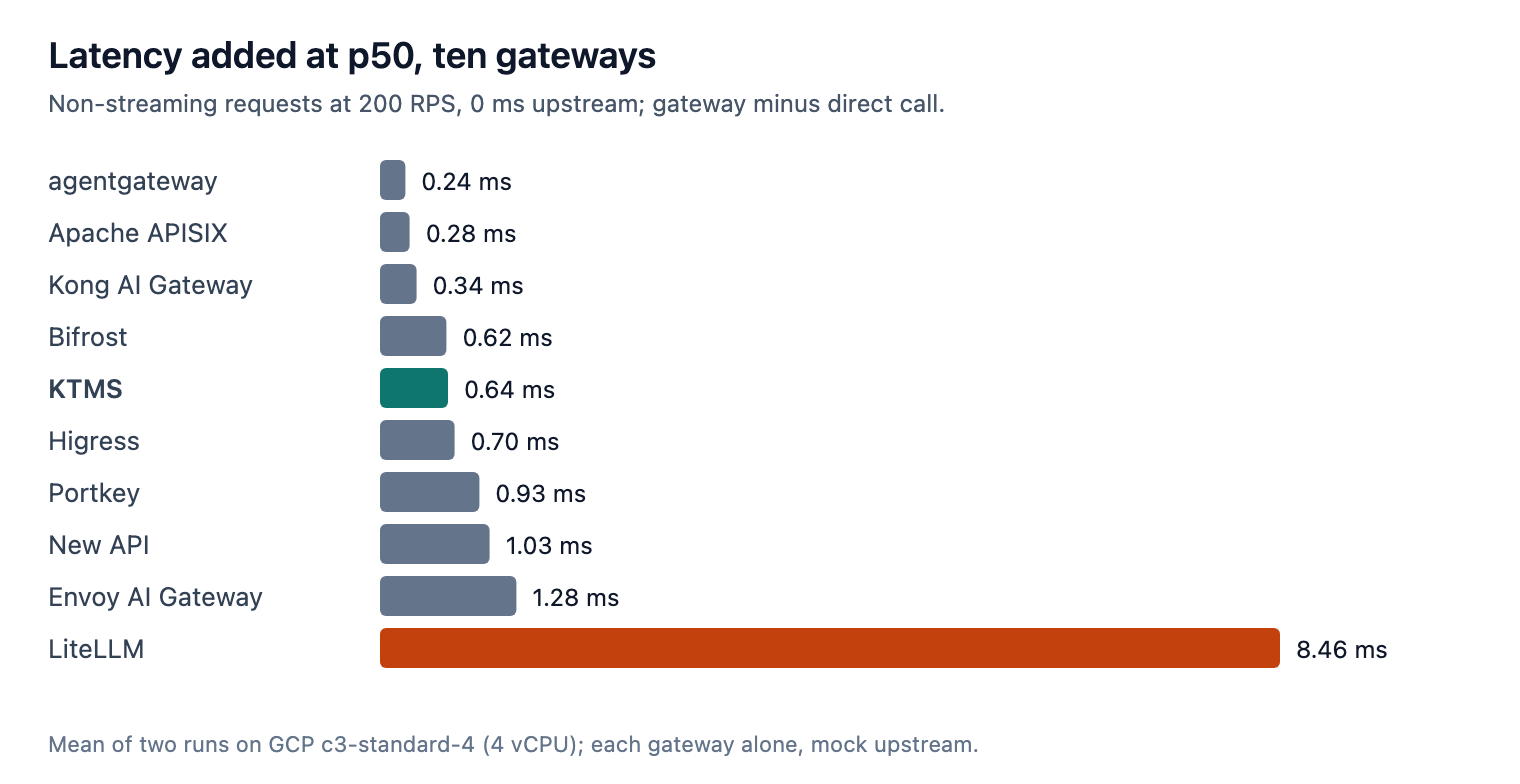
Вся эта маршрутизация — в одном Go-процессе. На нашем стенде (Google Cloud c3-standard-4, 4 vCPU, mock-апстрим, два прогона) Keystone добавлял около 0,64 мс на p50 и 1,1 мс на p99 при 200 RPS и держал не меньше 4000 RPS. Поверх задержки модели в сотни миллисекунд это шум.
Чего мы не умеем
Провайдеров меньше, чем у крупных шлюзов. OpenAI, Anthropic, Gemini, DeepSeek, Groq, Mistral, Azure OpenAI, Bedrock, любые OpenAI-совместимые серверы и TypeSafe для решений. Если вам нужен экзотический вендор, его может не быть.
Мы не самые быстрые. agentgateway, Apache APISIX и Kong добавляют меньше задержки на запрос.
Лимиты требуют Redis. Без него лимиты не применяются, а при его отказе лимиты запросов и токенов пропускают трафик. Для денег можно выбрать строгий режим
SPEND_LIMITS_FAIL_MODE=closed.Выбор сложности судьёй экспериментальный и требует настроенной модели-судьи.
Итог
Если убрать из микросервисов имя модели, исчезают сразу четыре проблемы: обновление моделей, отказы вендоров, атрибуция расходов и перевод простых задач на дешёвые модели. Всё это становится конфигурацией одного места. Keystone — одна из реализаций такой схемы, open source под Apache 2.0.
Репозиторий: github.com/ai-process/ktms
Документация: ai-process.dev
Как работает
model: "auto"подробно: в блоге
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.