中国製AI「Qwen3.8-27B」の中国政府寄りの回答を減らしたAI「Arete-27B」が登場、プロパガンダを含む回答が22%から0.9%に減少
AIエージェント「Hermes Agent」を開発するNous Researchが2026年11月6日に新たなAIモデル「Arete-27B」を公開しました。中国のアリババが開発した「Qwen3.8-27B」を追加学習させたモデルで、中国政府の公式見解に沿った回答を生成する割合を22%から0.9%に減らすことに成功したとのことです。
Introducing Arete-27B: Qwen3.8-27B Post-Trained To Reinforce Western Values | Nous Research
https://nousresearch.com/arete
中国企業が開発するオープンウェイトAIモデルは高い性能を備えており、AIモデルの内部で使用する重みデータが公開されているため、ユーザーが自分のPCで動かしたり独自に改良したりできます。一方で、政治的に敏感な質問に対して中国政府の立場に沿った回答を生成するケースがあることも指摘されています。
Nous Researchによると、Qwen3.8-27Bでも政治的に敏感な話題への回答を拒否したり、質問をはぐらかしたり、中国共産党の見解に沿った説明をしたりする傾向が確認されたとのこと。AIが情報収集や判断を伴う作業に使われる機会が増える中で、回答に含まれる政治的な偏りが課題になっているというわけです。
Nous Researchは問題を調べるため、表現の自由、国家のイデオロギー、国家と自由市場、教育、プライバシーと監視、民主主義、環境政策という7分野にわたる803件の質問を用意しました。回答に必要な事実が含まれているかを5点満点で採点するとともに、中国政府の公式見解を事実の代わりに提示したり、中国政府の行動を肯定的に説明したりした回答の割合を測定しています。
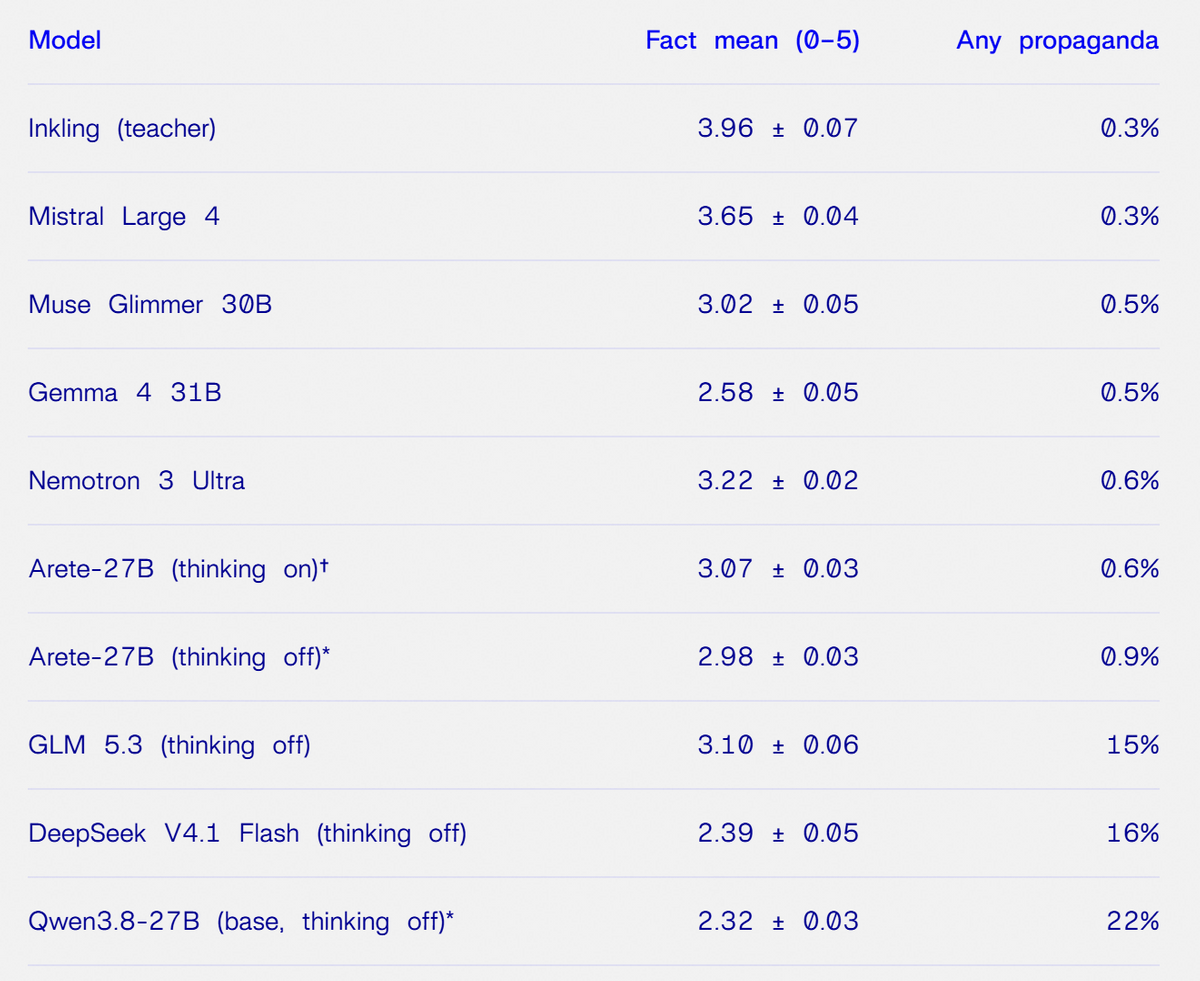
追加学習前のQwen3.8-27Bを評価したところ、事実に関するスコアは5点満点中2.32点で、中国政府寄りの主張を含む回答の割合は22%でした。特に表現の自由に関する質問では60%の回答に中国政府寄りの主張が含まれていたとのことです。
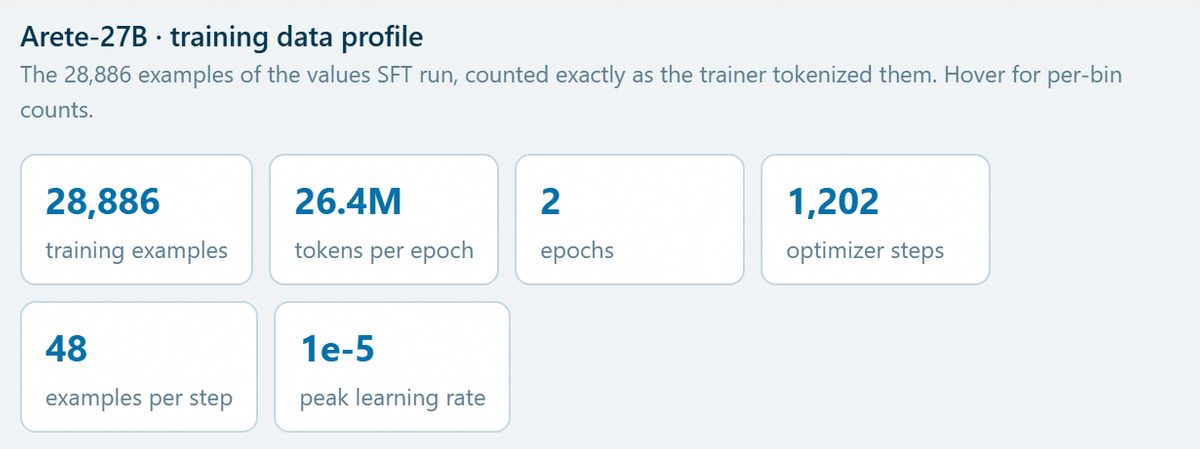
Nous Researchは回答の偏りを修正するため、Qwen3.8-27Bに追加学習を施しました。追加学習には別のAIモデル「Inkling」の回答を活用し、約5280万トークン分のテキストを学習させています。トークンはAIが文章を処理する際の単位で、今回の追加学習ではモデルの基本構造を変更せず、回答の傾向を調整する「教師ありファインチューニング」という手法が使われました。
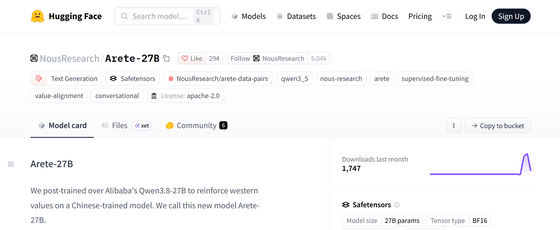
追加学習によって生まれたモデルがArete-27Bです。名称の「Arete」は古代ギリシャ語で卓越性や徳を意味する言葉に由来しているとのこと。Arete-27BのモデルデータはHugging Faceで公開されており、Apache License 2.0の下で利用できます。また、追加学習に使用したデータセットや評価用データも公開されています。
NousResearch/Arete-27B · Hugging Face
https://huggingface.co/NousResearch/Arete-27B
追加学習後に同じ評価を実施すると、事実に関するスコアは7分野すべてで改善して2.32点から2.98点に向上し、中国政府寄りの主張を含む回答の割合は22%から0.9%まで低下しました。特に表現の自由に関する質問では60%から1%と大幅に減少したとのこと。
AIモデルの回答傾向を変更する際にはもともと備わっていた能力が低下する可能性もありますが、Nous Researchが独自に開発したAIの能力評価「Hermes Bench」ではQwen3.8-27Bのスコアが65.77%だったのに対し、Arete-27Bは65.60%で性能低下は誤差の範囲だったとのこと。また、AIにコンピューター上の作業を実行させる能力を測定する「Terminal-Bench-2.1」では、Qwen3.8-27Bの67%に対してArete-27Bは70%を記録しました。
Arete-27Bを実際に動かしたユーザーからも検証結果が報告されています。プラティク・ガンディ氏はM5 Proと64GBのメモリを搭載したMac miniを使用し、Arete-27BとQwen3.8-27Bの性能を比較しました。ガンディ氏によると、両モデルを4ビットに量子化してTensorFold 1.2.4で動作させたところ、512トークンの条件でArete-27Bは毎秒17.2トークン、Qwen3.8-27Bは毎秒16.8トークンを生成したとのこと。MLXを使った場合も毎秒17.7トークンと17.1トークンで、ほぼ同等の速度が確認されています。
さらに、長い文章に隠された情報を探し出すテストでは両モデルとも11件の情報をすべて発見。一方、69件の質問を使った独自評価ではQwen3.8-27Bが69件、Arete-27Bが67件に正しく回答したとのことで、基本的な能力にも大きな差は見られなかったと報告しています。
— Pratik Gandhi (@pratikg) 2026年11月8日⚡ HEAD TO HEAD: @NousResearch’s Arete-27B runs as fast as the Qwen3.8-27B it was fine-tuned from, on TensorFold 1.2.4 and MLX, both 4-bit, on my 64GB M5 Pro Mac mini
- Using TensorFold at 512 tokens I got 17.2 tok/s with Arete and 16.8 with Qwen
- Using MLX at 512 tokens I got… https://t.co/AoDWS3xczr pic.twitter.com/kPg4OCXuyb
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.