同じ問題を解決してもAIによってコードの増加量に大きな差、AIモデルを比較するベンチマーク「Parsimony」が登場
AIがプログラムを修正する際に追加したコードと削除したコードの差を測定するオープンソースのベンチマーク「Parsimony」が公開されました。従来のベンチマークで重視されてきた問題の解決率やコストに加えて、コードの増加量からAIモデルを比較できるのが特徴です。
Parsimony: which AI coding agent changes the least code?
https://parsimony.lasu.dev/
AIを使ったプログラミングでは、AIがどれだけ正確に問題を解決できるかが重要な評価基準となっています。一方で、AIが問題を解決できたとしても、必要以上に複雑な処理や大量のコードを追加してしまう場合があります。コードが肥大化すると内容の確認や修正に手間がかかり、長期的なソフトウェアの保守が難しくなってしまいます。
ParsimonyはAIが追加したコードの量を数値化することで、従来のベンチマークでは見えにくかった違いを比較するために開発されました。Parsimonyの測定では既存のベンチマークで公開されたAIの修正データについて修正前と修正後の状態を解析し、追加されたコードと削除されたコードの量を調べるとのこと。
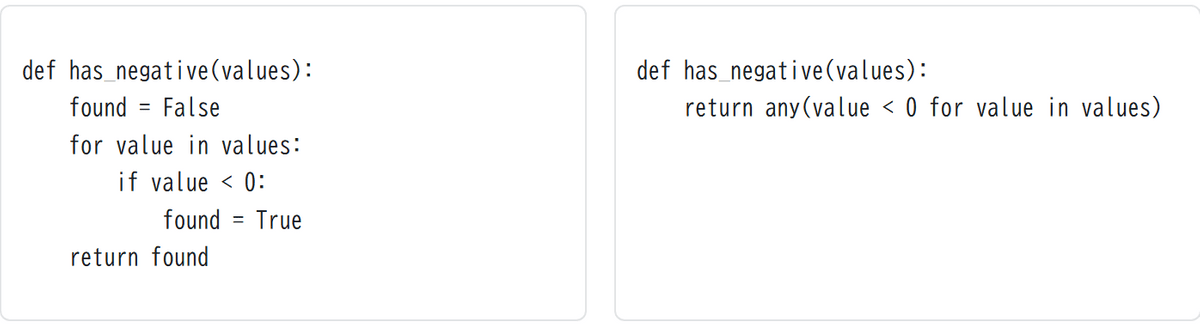
コードの量を測定する際には単純な行数ではなく「コーディングユニット」という単位を使用します。コーディングユニットは条件分岐や関数の呼び出し、変数名、数値などの構文要素を数えたもの。改行や空白、コメントなどは計算に含まれないため、複数行のコードを1行に詰め込むだけでは評価が改善しないようになっています。例えば、以下の画像は左右で同じユニット数だと評価されるとのこと。なお、テスト用のコードや説明文書、自動生成されたファイルなどは測定対象から除外されます。
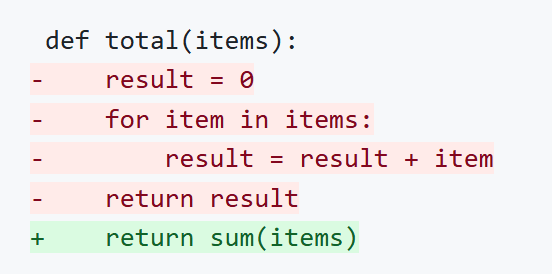
また、追加されたユニット数から削除されたユニット数を差し引くため、既存の処理を簡潔に書き直した場合にはマイナスの値になることもあります。下図の場合、数値の合計を求める繰り返し処理がPythonの標準機能「sum」に置き換えられていますが、変更前のコードから13ユニットが削除されて3ユニットが追加されるため差し引き10ユニットの削減となります。
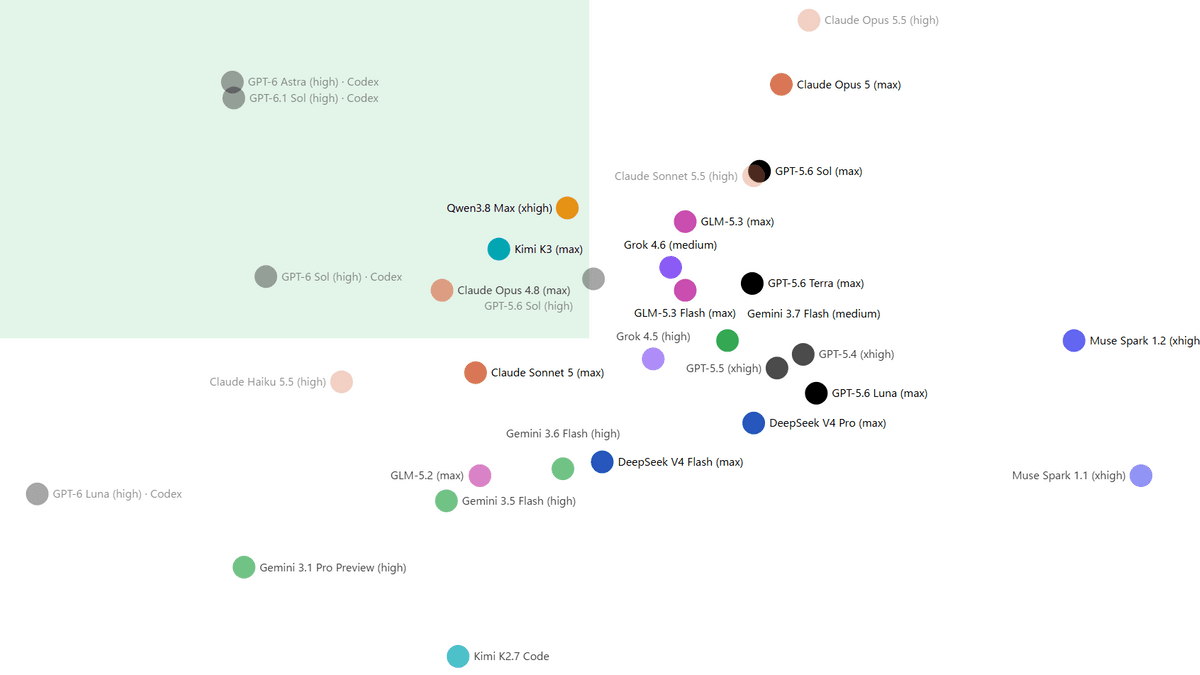
以下の画像はParsimonyによるAIモデルの比較結果です。横軸は同じ課題を解決した他のAIモデルと比較したコードの増加量で、左側ほど追加されたコードが少ないことを示しています。縦軸はAI評価サイト「Artificial Analysis」が算出したAIモデルの総合性能を示す指標「Intelligence Index」で、上側ほど高い評価を受けていることを意味します。比較結果を見ると、知能指数が高いAIモデルでもコードの追加量には大きな差があることが分かります。例えばClaude Opus 5.5(high)は知能指数が約54で、コードの増加量は他のモデルの約1.1倍でした。一方、GPT-6.1 Sol(high)・Codexは知能指数が約50で、コードの増加量は約0.7倍に収まっています。
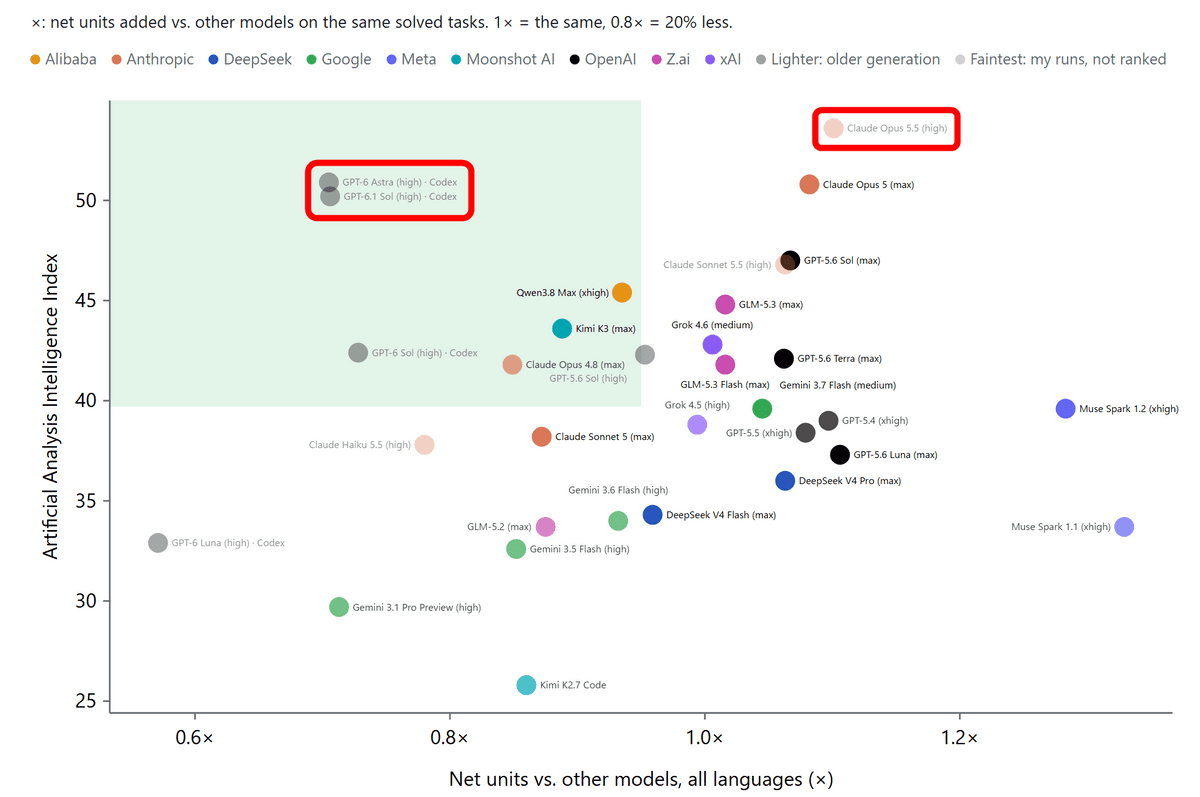
なお、コードの量が少ないほど品質が高いとは限らない点に注意が必要とのこと。短すぎるコードは処理内容を理解しにくくなる場合があり、Parsimonyの開発者はコードの量だけで読みやすさや設計の良しあしを評価できるわけではないと説明しています。
Parsimonyのソースコードと測定データはGitHubで公開されており、公開データを使って測定結果を再現することも可能です。開発者は今後さらに多くのAIモデルを比較できるよう、新しいモデルの修正データや評価方法に関する意見を募集しているとのことです。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.