脱獄したPlayStation 5のGPUでllama.cppを実行できる「PS5LM Plus」

PS5LM Plusの使い方は以下のような感じ。PS5LM Plusはソニー公式のアプリではないため、まずは脱獄済みのPS5本体と非公式アプリの実行に必要なツールを用意し、PS5LM Plusをホーム画面に登録。そして、PS5LM Plusを起動して使いたいAIモデルを選ぶと、PS5と同じネットワークに接続したPCやスマートフォンから質問を送れるようになり、PS5上で動くAIモデルが回答を生成します。
PS5LM Plusではllama.cppが対応するGGUF形式のモデルファイルを利用でき、PS5の内蔵ストレージだけでなく、増設したM.2 SSDやUSBドライブに保存したファイルも直接読み込めます。また、AIモデルの共有サイト「Hugging Face」からモデルを探してダウンロードする機能も備えており、モデルの入手から実行までをPS5上で行えます。
以下のモデル選択画面では、各モデルの容量に加え、PS5の空きメモリで動かせるかどうかも確認可能。モデルを選ぶと、一度に扱える文章量の上限や、会話の計算結果を一時保存するキャッシュの設定が空きメモリに合わせて自動調整されるため、メモリの割り当てを細かく設定せずに起動できます。
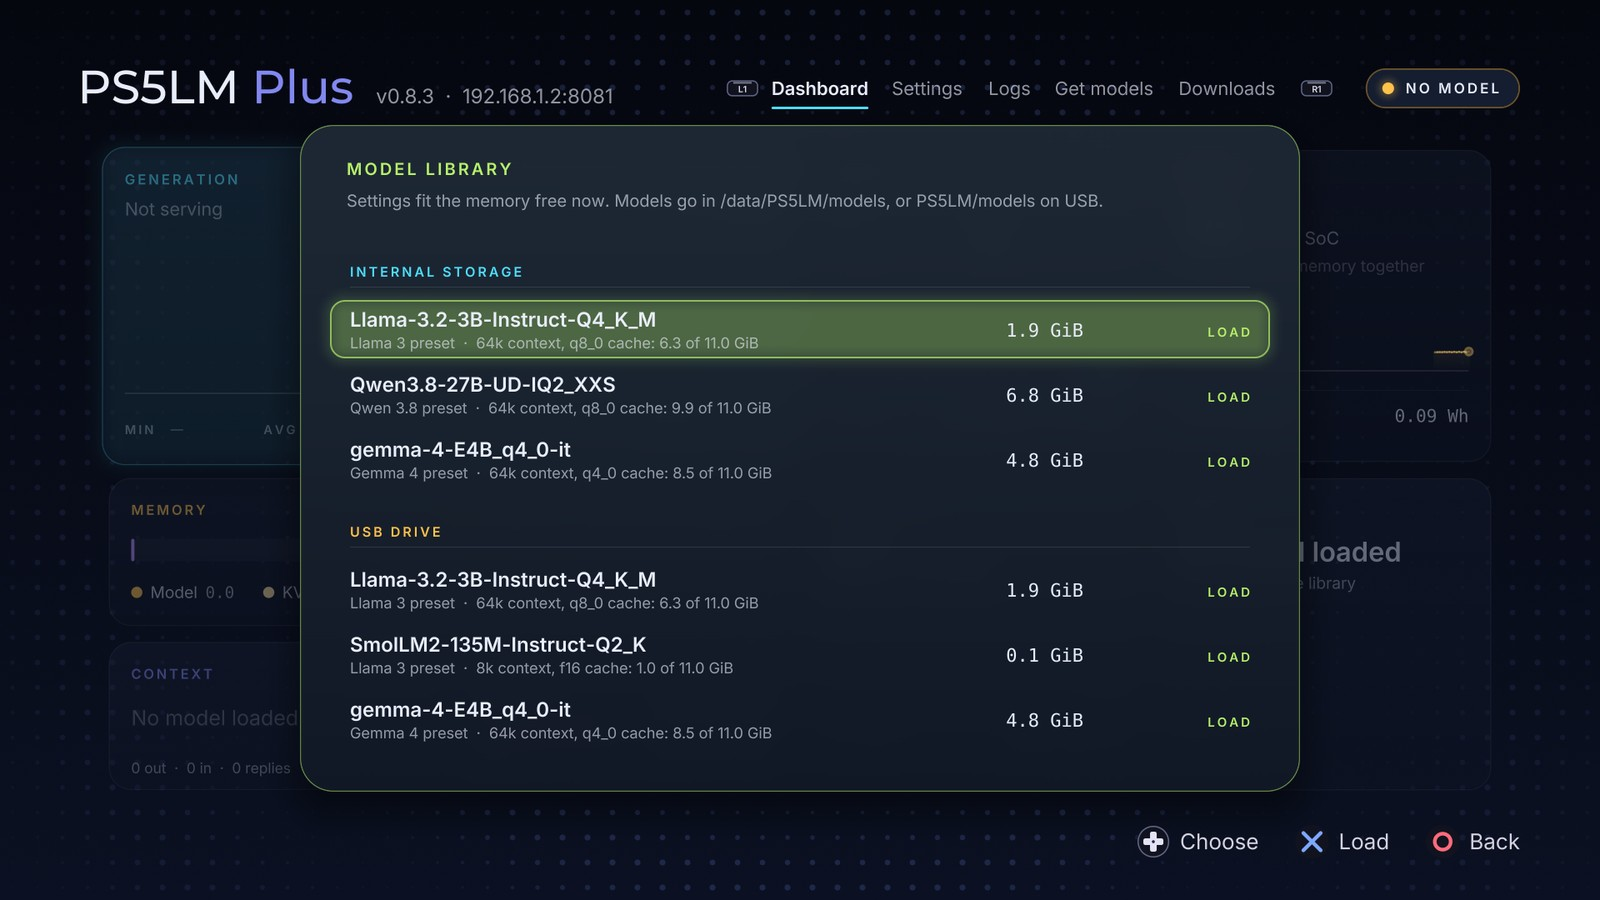
開発者によると、脱獄後に読み込むプログラム「ペイロード」としてllama.cppを動かす場合は、利用できるメモリが約6GiBに限られ、GPUも使えないとのこと。そのためPS5LM Plusはホーム画面から起動するアプリとして作られており、12GiBのメモリとGPUを利用できます。GPUでの計算には、GPUを扱うAPI「Vulkan」に対応したllama.cppの機能と、PS5向けに移植されたドライバーを組み合わせています。
開発者の計測では、パラメーター数が270億のモデル「Qwen3.8-27B」の量子化版「UD-IQ2_XXS」が、毎秒20.7トークンで文章を生成しました。トークンはAIが文章を処理する際の単位で、単語や単語の一部などに相当します。量子化はモデル内の数値の精度を下げてデータ量を減らす手法で、UD-IQ2_XXS版の容量は6.8GiBです。以下のモデル詳細画面では、質問や過去の会話、生成する回答を合わせて最大6万5536トークンを扱う設定になっています。
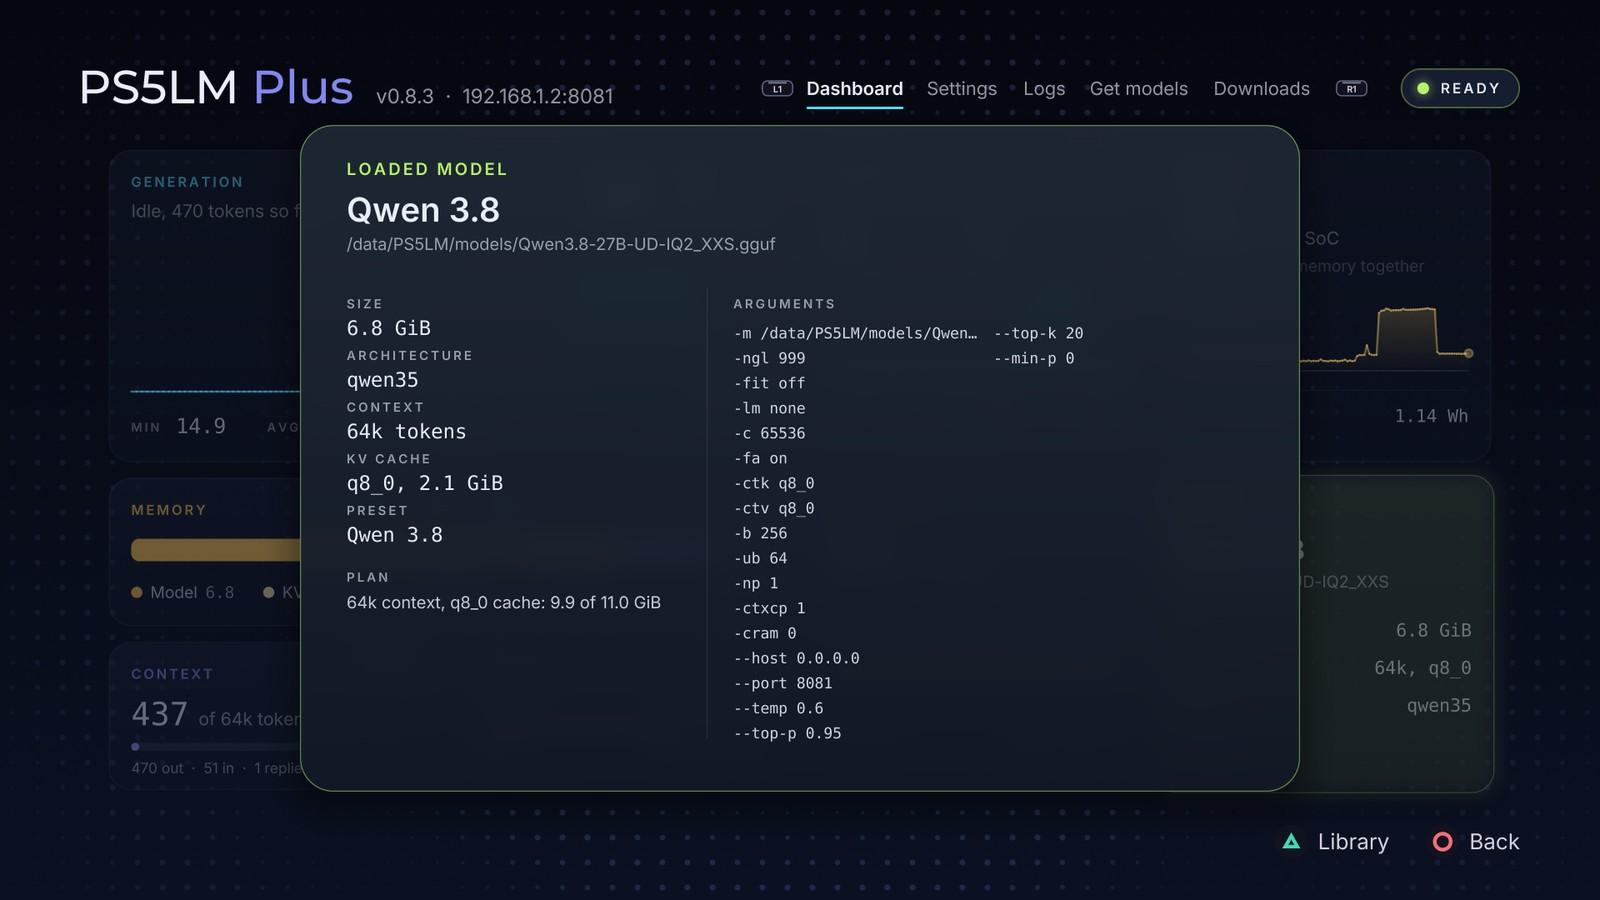
なお、開発者は容量1.9GiBの小型モデル「Llama 3.2 3B Instruct Q4_K_M」をUSBドライブから読み込んだテストで、毎秒124トークンの生成速度も記録しています。
また、PS5につないだテレビのダッシュボードでは、文章の生成速度やGPU・CPUの使用率、温度のほか、モデル本体とキャッシュがそれぞれどれだけメモリを使っているかも確認可能。
PS5と同じネットワークに接続したPCやスマートフォンのブラウザで、アドレス欄に「http://【PS5のIPアドレス】:8081」と入力してアクセスするとllama.cppのチャット画面が開き、入力した質問への回答をPS5上のモデルが生成します。以下はPCのブラウザから「Llama 3.2 3B」に質問した画面。
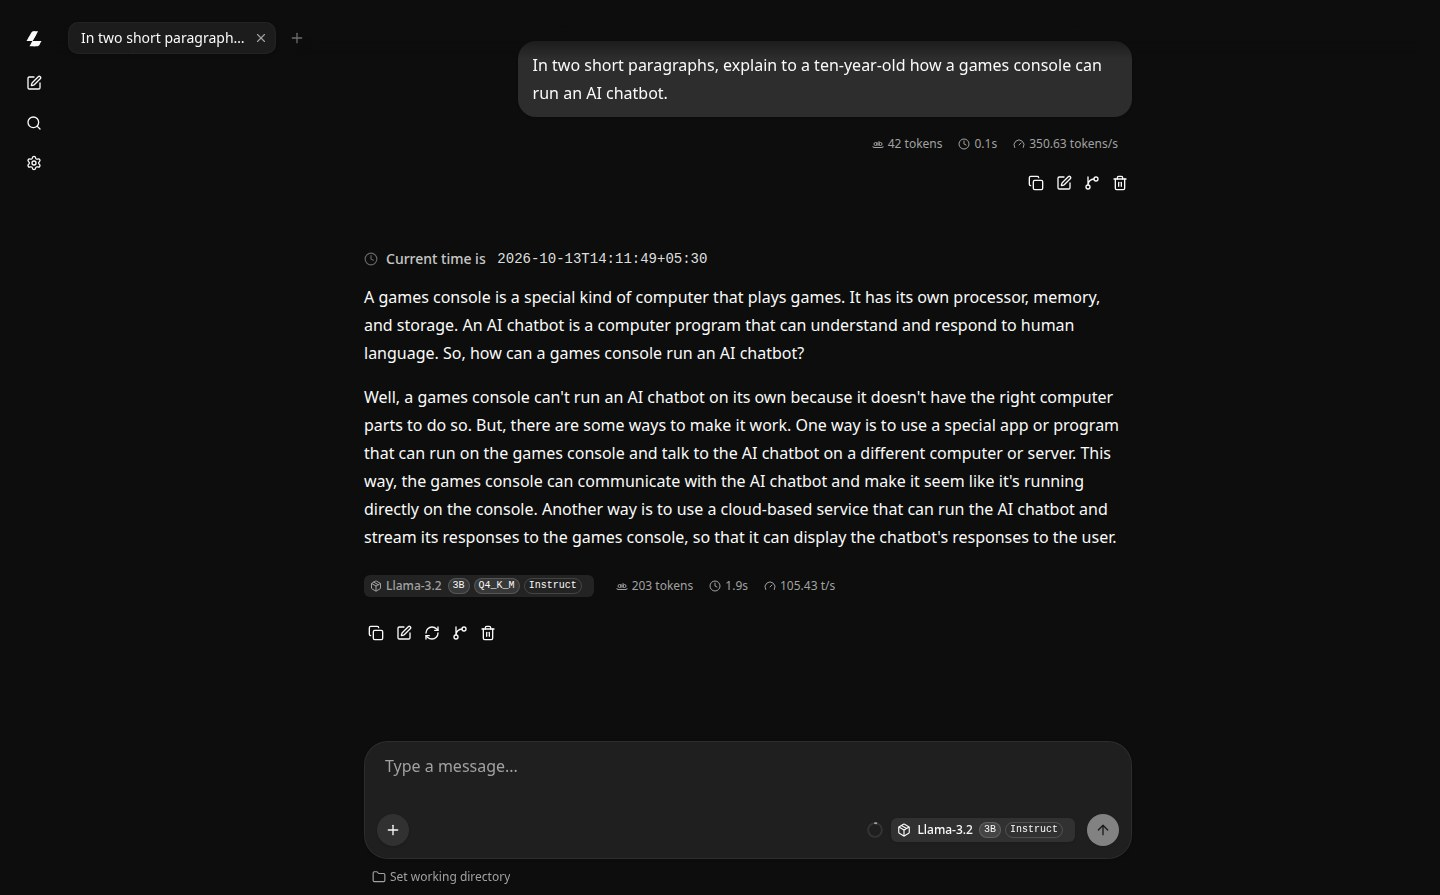
また、Gemma 4などの画像入力に対応したモデルと、そのモデル用の画像処理ファイルを用意すれば、チャット画面で画像を添えて質問することもできます。
さらに、PS5LM PlusのAPIはOpenAIやAnthropicのAPIと互換性があり、opencode・Codex・Claude Codeなどのコーディング支援ツールからPS5上のモデルにコードの編集を指示することも可能です。開発者はこれらのツールをPS5上のモデルに接続し、Pythonファイルに2つの値を足す関数を追加するよう指示したところ、いずれのツールでもファイルを編集できたと報告しています。
ただし、質問や指示を送ってから回答が始まるまでには、入力を処理する時間もかかります。開発者によると、Qwen3.8-27Bが質問や指示を処理する速度は毎秒35~50トークンで、2万トークンを入力する場合、回答が始まるまでに数分かかるとのこと。
コーディング支援ツールは作業の指示に加えてツールの使い方などもモデルに送るため入力が長くなりやすく、開発者はこうした用途にはGemma 4 E4Bなどの小型モデルを勧めています。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.