Маленький «мозг» с большими возможностями, или Как я Альфе NPU прикручивал, чтобы было с кем поболтать
Привет, Хабр!
В прошлой статье я кратко упомянул о третьей версии своего PET-проекта — голосового ассистента с функциями управления умным домом, не зависящего от сторонних сервисов. Новая версия отличается от двух предыдущих появлением нейропроцессорного модуля, что значительно расширяет возможности голосового ассистента. В этой статье я попытаюсь описать процесс интеграции NPU в проект «Альфы». А что из этого получилось — читайте далее.
Начало
Просто иногда хочется поговорить с умной колонкой, словно с Алисой, Алексой и etc. Прошлые версии «Альфы» прекрасно работают как «голосовой выключатель» для управления умным домом, обеспечивая приватность и независимость от внешних интернет-сервисов, потенциально сохраняя работоспособность даже во время апокалипсиса. В общем, захотелось что-то душевное и более живое, а не эту бездушную коробку.
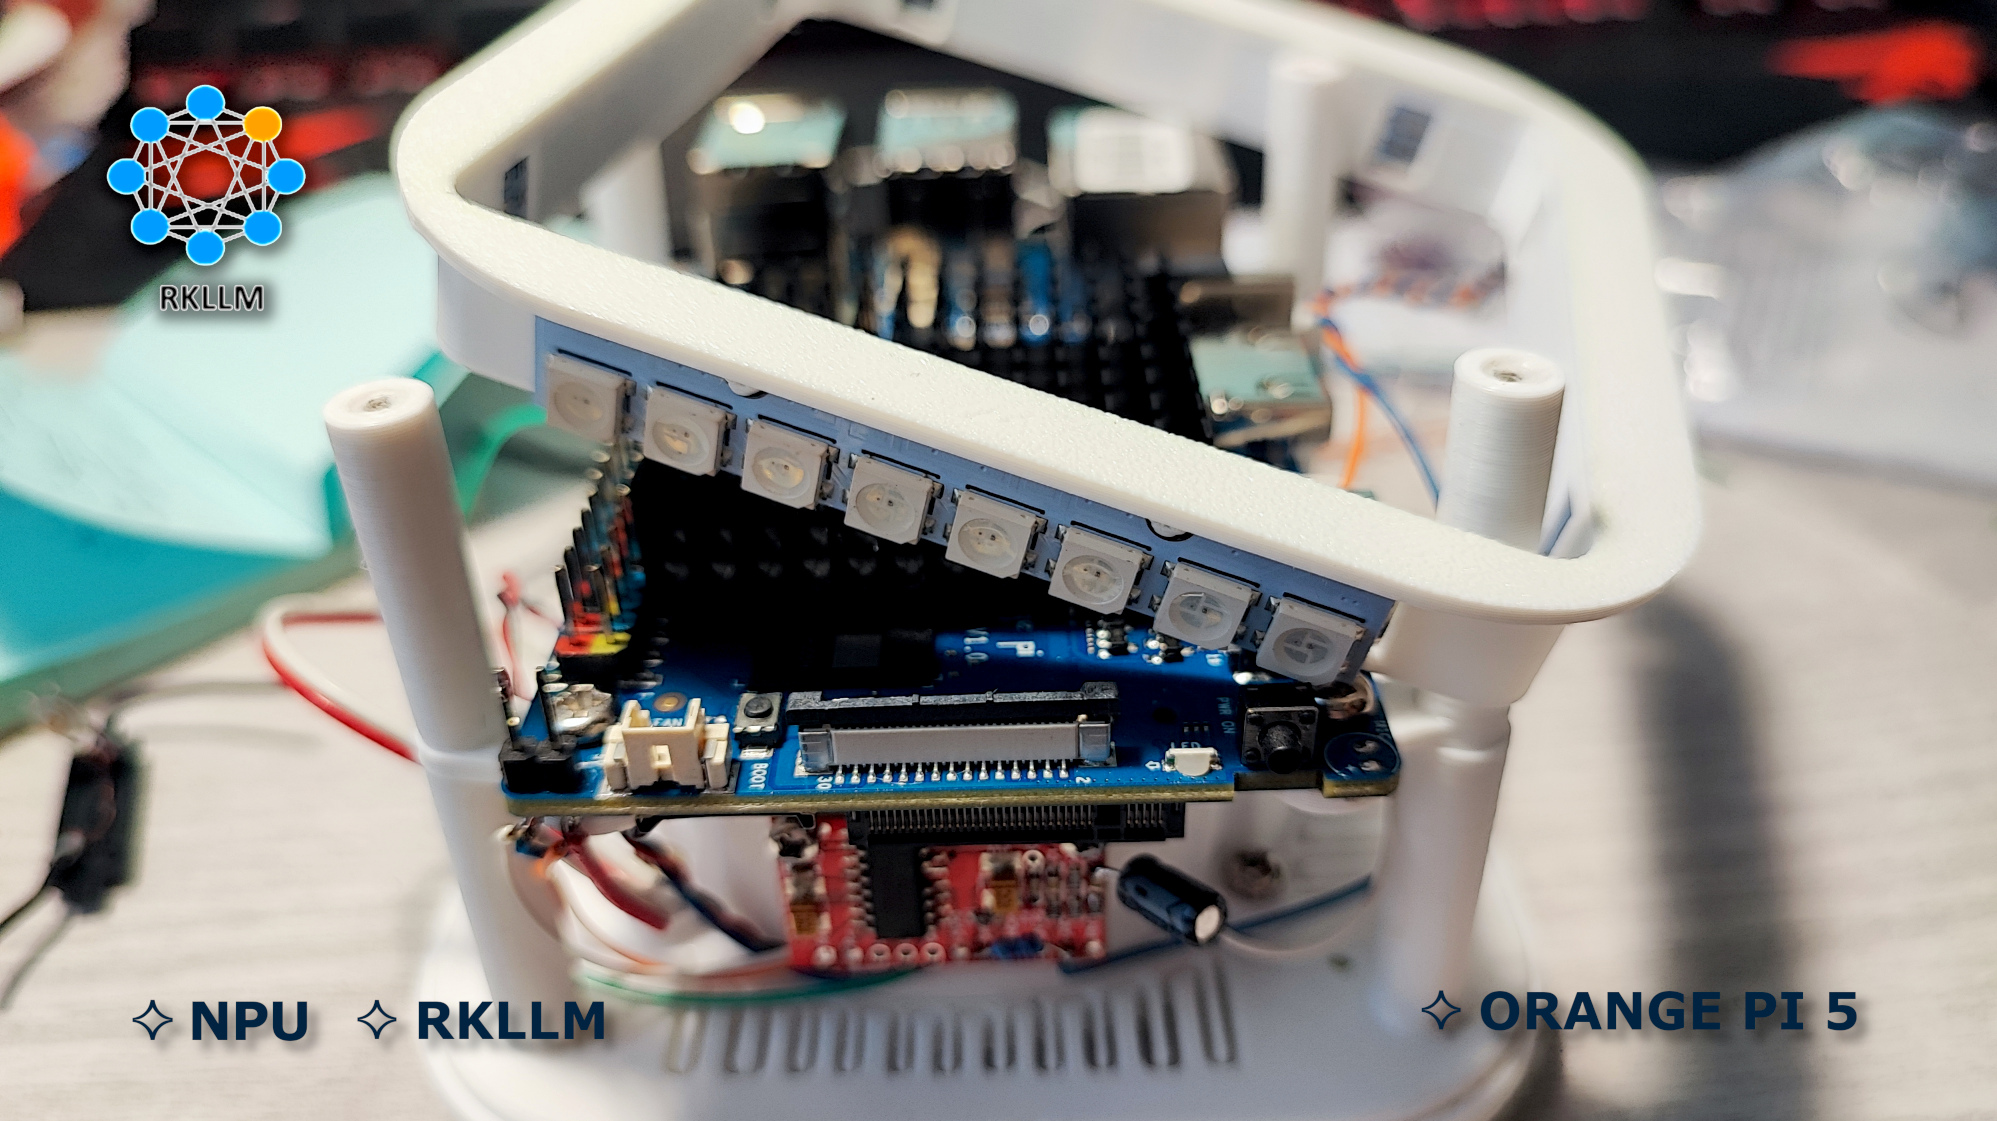
Вся история началась чуть больше года назад. По случайному совпадению, на тот момент у меня появился новый 3D-принтер и одноплатный компьютер OrangePi 5 Ultra с 16 ГБ оперативной памяти, последний мне удалось купить (не с первой попытки) за 25 тыс. рублей, что во времена сегодняшнего полупроводникового кризиса сущие копейки. Поэтому, имея данный кейс, мне очень хотелось реализовать какой-то проект и этим каким-то проектом стала новая «душевная» версия «Альфы».
И коротко о железе
И как уже я упомянул ранее, аппаратная платформа для новой «Альфы» реализована на плате OrangePi 5 Ultra. Сердцем данной платы является SoC Rockchip RK3588, который в своем составе содержит модуль NPU поддерживающий гибридные вычисления INT4/INT8/INT16/FP16 с производительностью 6 TOPS — самое то, чтобы Альфу сделать более разговорчивой.
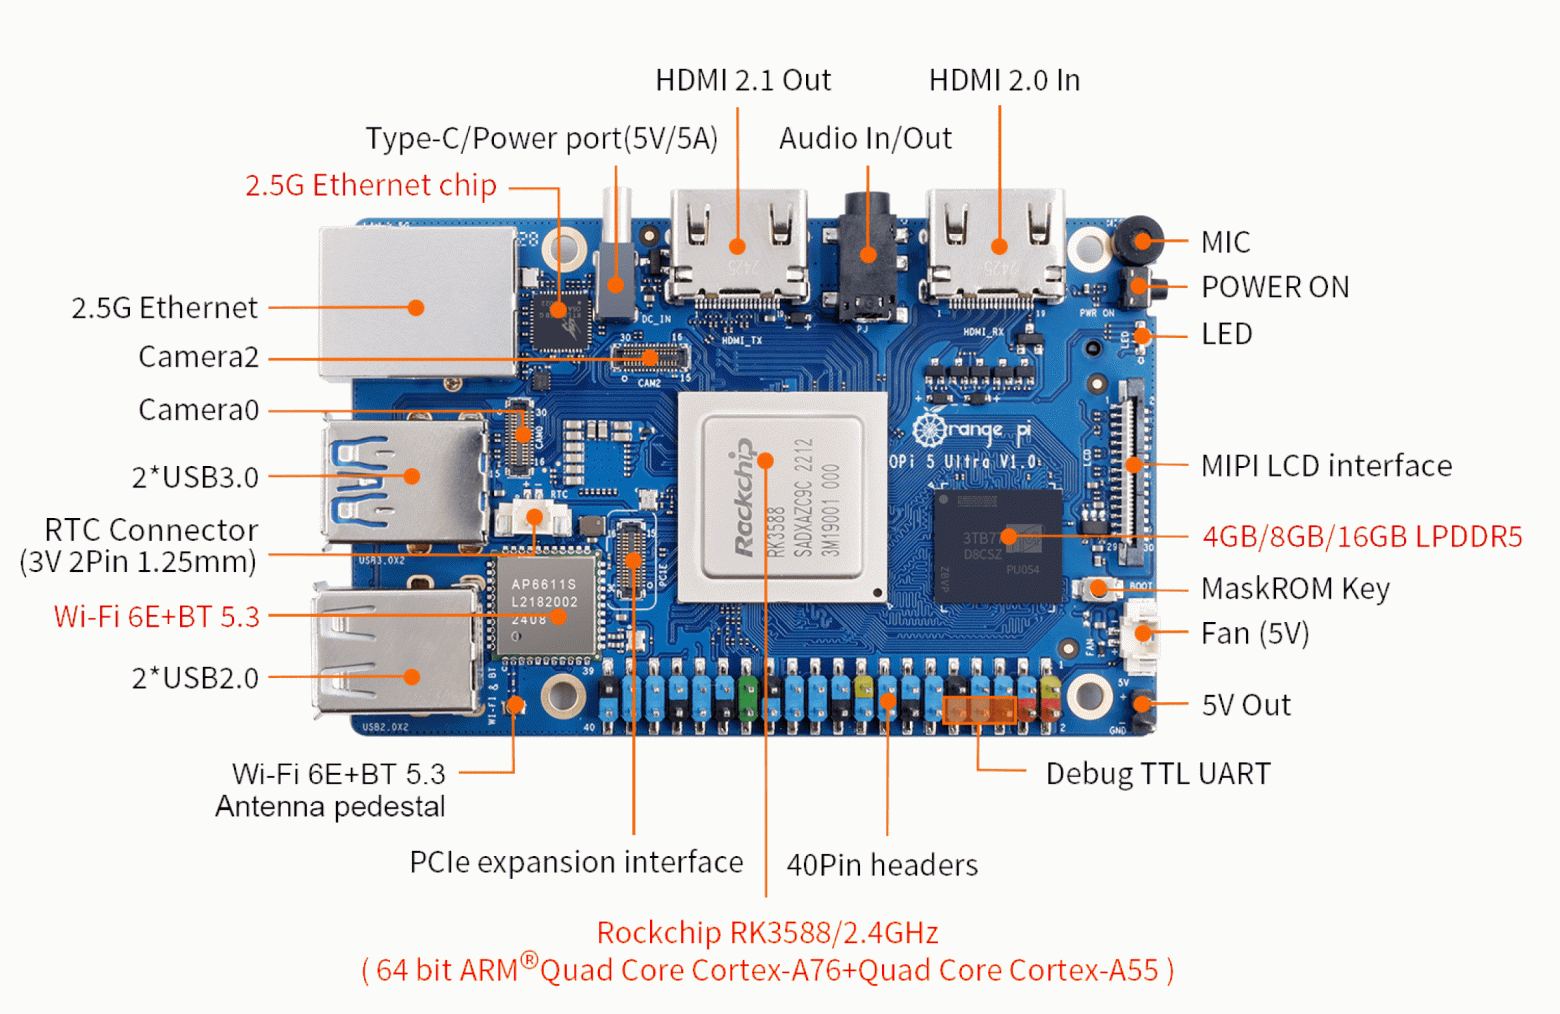
Плата поддерживает подключение eMMC модуля, поэтому в качестве постоянной памяти использую модуль ёмкостью 256 ГБ.
Описание полной аппаратной реализации «Альфы» достаточно объёмное — это тема для отдельной статьи с кучей тонкостей, поэтому, с вашего позволения, в этой статье я не буду их касаться.
Шаг программный. Первое касание NPU
После настройки аппаратной части переходим к программной. Как я уже писал, в качестве ОС используется Debian 13 (образ взят с сайта производителя Orange Pi). Код предыдущей версии «Альфы» после настройки аудиоподсистемы полностью совместим, остаётся написать новый модуль для работы с NPU. Для начала разберёмся, как с ним взаимодействовать.
Прежде чем идти дальше, нам необходимо убедиться в наличии драйвера NPU с помощью команды:
sudo cat /sys/kernel/debug/rknpu/versionКак правило, драйвер уже присутствует в скачанном образе операционной системы, и мы должны увидеть следующий вывод в консоли:
RKNPU driver: v0.9.8Если у вы видите что-то подобное, то до запуска локальной LLM осталось пару шагов. Для начала установим среду выполнения для запуска моделей, которую мы можем взять из официального репозитория Rockchip. Данный репозиторий содержит стек программного обеспечения RKLLM для быстрого развертывания моделей ИИ на чипах Rockchip.
Сначала пришлось немного поломать голову, чтобы разобраться с установкой rkllm-runtime на Orange Pi 5 Ultra под Debian 13. Чтобы избавить вас от этих мучений, я упаковал все этапы установки в один скрипт:
install_rkllm.sh
#!/bin/bash
# Установка официального RKLLM Runtime и llm_demo на Orange Pi 5 Ultra (RK3588)
# Проверяет NPU, чинит apt при битых сторонних репозиториях,
# правит build-linux.sh под нативную сборку и патчит src/llm_demo.cpp
set -e
echo "===> 1. Проверка версии драйвера NPU (не критично для установки)..."
if [ -f /sys/kernel/debug/rknpu/version ]; then
cat /sys/kernel/debug/rknpu/version
echo "✅ Файл версии найден."
else
echo "⚠️ Не удалось прочитать /sys/kernel/debug/rknpu/version."
echo " Возможные причины: debugfs не смонтирован, нет прав или драйвер отсутствует."
echo " Попробуйте: sudo mount -t debugfs none /sys/kernel/debug && sudo cat /sys/kernel/debug/rknpu/version"
echo " Или проверьте dmesg | grep -i rknpu"
echo " ⚠️ Продолжаем установку, но RKLLM может не работать без драйвера ≥ 0.9.8."
fi
echo ""
echo "===> 2. Проверка и починка apt (на случай битых сторонних репозиториев)..."
if ! sudo apt update 2>/dev/null; then
echo "⚠️ apt update завершился с ошибкой. Комментируем сторонние .list-файлы..."
for f in /etc/apt/sources.list.d/*.list; do
[ -f "$f" ] || continue
# Пропускаем основные репозитории Debian (если они лежат в sources.list.d)
if grep -qE "deb\.debian\.org|security\.debian\.org" "$f"; then
continue
fi
sudo sed -i 's/^deb /#deb /' "$f"
echo " → Закомментирован $f"
done
sudo apt update
else
echo "✅ apt update прошёл без ошибок."
fi
echo ""
echo "===> 3. Установка системных зависимостей..."
sudo apt install -y git cmake build-essential python3-pip
echo ""
echo "===> 4. Клонирование официального репозитория rknn-llm..."
if [ -d "rknn-llm" ]; then
echo "Папка rknn-llm уже существует, пропускаем клонирование."
else
git clone https://github.com/airockchip/rknn-llm.git
fi
cd rknn-llm
echo ""
echo "===> 5. Установка библиотеки Runtime (librkllmrt.so)..."
LIB_SRC_DIR="rkllm-runtime/Linux/librkllm_api/aarch64"
if [ -f "$LIB_SRC_DIR/librkllmrt.so" ]; then
sudo cp "$LIB_SRC_DIR/librkllmrt.so" /usr/lib/
sudo ldconfig
echo "✅ librkllmrt.so установлена в /usr/lib/"
else
echo "❌ Ошибка: файл библиотеки не найден по пути $LIB_SRC_DIR"
echo " Проверьте структуру репозитория: ls rkllm-runtime/"
exit 1
fi
echo ""
echo "===> 6. Компиляция официальной демонстрационной программы llm_demo..."
DEMO_DIR="examples/rkllm_api_demo/deploy"
if [ ! -d "$DEMO_DIR" ]; then
echo "❌ Папка с примером не найдена: $DEMO_DIR"
echo " Проверьте: ls rkllm-runtime/examples/"
exit 1
fi
cd "$DEMO_DIR"
# --- 6a. Автоматическое исправление build-linux.sh под нативную сборку ---
echo ""
echo "===> 6a. Исправление build-linux.sh (замена кросс-компилятора на системный)…"
BUILD_SCRIPT="build-linux.sh"
if [ -f "$BUILD_SCRIPT" ]; then
cp "$BUILD_SCRIPT" "${BUILD_SCRIPT}.bak"
if grep -q "GCC_COMPILER_PATH" "$BUILD_SCRIPT"; then
sed -i 's|^GCC_COMPILER_PATH=.*|# Заменено на системный компилятор (нативная сборка)\nC_COMPILER=$(which gcc)\nCXX_COMPILER=$(which g++)\nSTRIP_COMPILER=$(which strip)|' "$BUILD_SCRIPT"
sed -i '/^C_COMPILER=\${GCC_COMPILER_PATH}/d' "$BUILD_SCRIPT"
sed -i '/^CXX_COMPILER=\${GCC_COMPILER_PATH}/d' "$BUILD_SCRIPT"
sed -i '/^STRIP_COMPILER=\${GCC_COMPILER_PATH}/d' "$BUILD_SCRIPT"
echo "✅ build-linux.sh исправлен (GCC_COMPILER_PATH → системный gcc/g++)."
else
echo "ℹ️ GCC_COMPILER_PATH не найден — возможно, файл уже исправлен."
fi
echo " Текущие строки компиляторов:"
grep -E "^(C_COMPILER|CXX_COMPILER|STRIP_COMPILER|GCC_COMPILER_PATH)=" "$BUILD_SCRIPT" || true
else
echo "❌ Файл $BUILD_SCRIPT не найден в $DEMO_DIR"
exit 1
fi
# --- 6a-2. Патч src/llm_demo.cpp: метрики + брендинг «Альфы» ---
echo ""
echo "===> 6a-2. Патч src/llm_demo.cpp (метрики скорости и брендинг «Альфы»)…"
SRC_FILE="src/llm_demo.cpp"
if [ ! -f "$SRC_FILE" ]; then
echo "❌ Исходник не найден: $SRC_FILE"
echo " Проверьте структуру: ls src/"
exit 1
fi
cp "$SRC_FILE" "${SRC_FILE}.bak"
cat > "$SRC_FILE" <<'EOF'
// Copyright (c) 2025 by Rockchip Electronics Co., Ltd. All Rights Reserved.
// Modified for «Альфа» project (CYBEREX TECH): added generation metrics and branding.
#include <string.h>
#include <unistd.h>
#include <string>
#include "rkllm.h"
#include <fstream>
#include <iostream>
#include <csignal>
#include <vector>
#include <chrono>
#include <sstream>
using namespace std;
LLMHandle llmHandle = nullptr;
// ==== Метрики генерации ====
static std::chrono::steady_clock::time_point g_gen_start;
static std::chrono::steady_clock::time_point g_first_token;
static bool g_first_token_received = false;
static int g_token_count = 0;
static int g_char_count = 0;
static void reset_metrics() {
g_first_token_received = false;
g_token_count = 0;
g_char_count = 0;
}
static void print_metrics() {
auto now = std::chrono::steady_clock::now();
double total_ms = std::chrono::duration<double, std::milli>(now - g_gen_start).count();
double ttft_ms = 0.0;
if (g_first_token_received) {
ttft_ms = std::chrono::duration<double, std::milli>(g_first_token - g_gen_start).count();
}
double gen_ms = total_ms - ttft_ms;
double tps_total = (total_ms > 0.0) ? g_token_count / (total_ms / 1000.0) : 0.0;
double tps_gen = (gen_ms > 0.0) ? g_token_count / (gen_ms / 1000.0) : 0.0;
printf("\n");
printf("─────────────── METRICS ───────────────\n");
printf("Tokens generated : %d\n", g_token_count);
printf("Characters : %d\n", g_char_count);
printf("Total time : %.2f ms\n", total_ms);
printf("Time to 1st token: %.2f ms\n", ttft_ms);
printf("Generation time : %.2f ms\n", gen_ms);
printf("Speed (total) : %.2f tokens/s\n", tps_total);
printf("Speed (gen only) : %.2f tokens/s\n", tps_gen);
printf("───────────────────────────────────────\n\n");
}
void exit_handler(int signal)
{
if (llmHandle != nullptr)
{
cout << "程序即将退出" << endl;
LLMHandle _tmp = llmHandle;
llmHandle = nullptr;
rkllm_destroy(_tmp);
}
exit(signal);
}
int callback(RKLLMResult *result, void *userdata, LLMCallState state)
{
if (state == RKLLM_RUN_FINISH)
{
print_metrics();
} else if (state == RKLLM_RUN_ERROR) {
printf("\\run error\n");
} else if (state == RKLLM_RUN_NORMAL) {
if (!g_first_token_received) {
g_first_token = std::chrono::steady_clock::now();
g_first_token_received = true;
}
if (result->text != nullptr) {
g_token_count++;
g_char_count += (int)strlen(result->text);
}
if (result->last_hidden_layer.embd_size != 0 && result->last_hidden_layer.num_tokens != 0) {
int data_size = result->last_hidden_layer.embd_size * result->last_hidden_layer.num_tokens * sizeof(float);
printf("\ndata_size:%d",data_size);
std::ofstream outFile("last_hidden_layer.bin", std::ios::binary);
if (outFile.is_open()) {
outFile.write(reinterpret_cast<const char*>(result->last_hidden_layer.hidden_states), data_size);
outFile.close();
std::cout << "Data saved to output.bin successfully!" << std::endl;
} else {
std::cerr << "Failed to open the file for writing!" << std::endl;
}
}
printf("%s", result->text);
}
return 0;
}
int main(int argc, char **argv)
{
if (argc < 4) {
std::cerr << "Usage: " << argv[0] << " model_path max_new_tokens max_context_len\n";
return 1;
}
signal(SIGINT, exit_handler);
printf("rkllm init start\n");
RKLLMParam param = rkllm_createDefaultParam();
param.model_path = argv[1];
param.top_k = 1;
param.top_p = 0.95;
param.temperature = 0.8;
param.repeat_penalty = 1.1;
param.frequency_penalty = 0.0;
param.presence_penalty = 0.0;
param.max_new_tokens = std::atoi(argv[2]);
param.max_context_len = std::atoi(argv[3]);
param.skip_special_token = true;
param.extend_param.base_domain_id = 0;
param.extend_param.embed_flash = 1;
RKLLMCallback rkllm_callback = {};
rkllm_callback.result_callback = callback;
int ret = rkllm_init(&llmHandle, ¶m, &rkllm_callback);
if (ret == 0){
printf("rkllm init success\n");
} else {
printf("rkllm init failed\n");
exit_handler(-1);
}
vector<string> pre_input;
pre_input.push_back("Привет, Альфа! Расскажи, кто ты и что умеешь.");
pre_input.push_back("Альфа, расскажи историю.");
cout << "\n********************** CYBEREX TECH ********************\n"
<< "Введите номер примера из списка ниже или свой вопрос.\n"
<< "Команды: exit — выход, clear — очистить историю диалога.\n"
<< endl;
for (int i = 0; i < (int)pre_input.size(); i++)
{
cout << "[" << i << "] " << pre_input[i] << endl;
}
cout << "\n**************************************************************************************\n"
<< endl;
RKLLMInput rkllm_input;
memset(&rkllm_input, 0, sizeof(RKLLMInput));
RKLLMInferParam rkllm_infer_params;
memset(&rkllm_infer_params, 0, sizeof(RKLLMInferParam));
rkllm_infer_params.mode = RKLLM_INFER_GENERATE;
rkllm_infer_params.keep_history = 0;
while (true)
{
std::string input_str;
printf("\n");
printf("Вы: ");
std::getline(std::cin, input_str);
if (input_str == "exit")
{
break;
}
if (input_str == "clear")
{
ret = rkllm_clear_kv_cache(llmHandle, 1, nullptr, nullptr);
if (ret != 0)
{
printf("clear kv cache failed!\n");
}
continue;
}
for (int i = 0; i < (int)pre_input.size(); i++)
{
if (input_str == to_string(i))
{
input_str = pre_input[i];
cout << input_str << endl;
}
}
rkllm_input.input_type = RKLLM_INPUT_PROMPT;
rkllm_input.role = "user";
rkllm_input.prompt_input = (char *)input_str.c_str();
printf("Модель: ");
reset_metrics();
g_gen_start = std::chrono::steady_clock::now();
rkllm_run(llmHandle, &rkllm_input, &rkllm_infer_params, NULL);
}
rkllm_destroy(llmHandle);
return 0;
}
EOF
echo "✅ src/llm_demo.cpp пропатчен (резервная копия: ${SRC_FILE}.bak)."
# --- 6b. Запуск сборки ---
echo ""
echo "===> 6b. Запуск сборки…"
bash "$BUILD_SCRIPT"
DEMO_BIN=""
for candidate in "build/build_linux_aarch64_Release/llm_demo" "build/build_aarch64_Release/llm_demo" "install/demo_Linux_aarch64/llm_demo"; do
if [ -f "$candidate" ]; then
DEMO_BIN="$candidate"
break
fi
done
if [ -n "$DEMO_BIN" ]; then
sudo cp "$DEMO_BIN" /usr/bin/rkllm
echo "✅ Демонстрационная программа установлена как /usr/bin/rkllm"
else
echo "❌ Ошибка компиляции: исполняемый файл llm_demo не найден."
echo " Проверьте вывод сборки выше."
exit 1
fi
echo ""
echo "===> 7. Настройка лимита файловых дескрипторов..."
if ! grep -q "soft nofile 16384" /etc/security/limits.conf; then
echo "* soft nofile 16384" | sudo tee -a /etc/security/limits.conf
echo "* hard nofile 1048576" | sudo tee -a /etc/security/limits.conf
echo "✅ Лимит обновлён (вступит в силу после перезагрузки)."
fi
echo ""
echo "=========================================="
echo "✅ Установка завершена!"
echo "=========================================="
echo ""
echo "Использование:"
echo " rkllm <путь_к_модели.rkllm> 2048 4096"
echo ""
echo "⚠️ ВАЖНО: Если на шаге 1 драйвер NPU не был найден,"
echo " RKLLM не сможет работать. Убедитесь, что у вас установлен"
echo " образ с BSP-ядром Rockchip (а не mainline), и драйвер rknpu"
echo " версии ≥ 0.9.8 загружен."
echo ""
echo "Перед запуском рекомендуется выполнить:"
echo " ulimit -HSn 102400"Также в данном скрипте выполняется модификация llm_demo.cpp, которая добавляет вывод метрики для оценки скорости работы модели. Далее по классике, делаем скрипт исполняемым:
sudo chmod +x ~/install_rkllm.shи запускаем:
sudo ./install_rkllm.shИ после успешной установки мы можем попытаться запустить наш rkllm-runtime с помощью команды:
rkllmв результате выполнения мы увидим следующее:
Usage: rkllm model_path max_new_tokens max_context_lenгде нам любезно напоминают как использовать данную команду, где:
rkllm model_path - путь до нашей модели;
max_new_tokens - предел количества токенов, которые может сгенерировать модель в ответе;
max_context_len - максимальная длина контекста.
Теперь нас ничего не сдерживает, и мы можем выполнить тестовый запуск модели. Однако стоит учитывать, что из-за аппаратных особенностей чипа RK3588 для запуска модели требуется её конвертация и, как правило, с квантованием W8A8.
Для самостоятельной конвертации модели можно воспользоваться rkllm-toolkit или скачать уже сжатые модели под RK3588 с Hugging Face. Мы не ищем сложных путей, поэтому на этапе тестирования воспользуемся вторым вариантом. Протестируем запуск на модели Qwen3 с 1,7 миллиарда параметров. Для загрузки модели с Hugging Face не будем использовать специальные утилиты вроде huggingface_hub, а воспользуемся обычной консольной утилитой Wget:
wget -c "https://huggingface.co/GatekeeperZA/Qwen3-1.7B-RKLLM-v1.2.3/resolve/main/Qwen3-1.7B-w8a8-rk3588.rkllm?download=true" -O Qwen3-1.7B-w8a8-rk3588.rkllmПосле успешной загрузки, мы можем запустить модель с помощью команды:
rkllm Qwen3-1.7B-w8a8-rk3588.rkllm 2048 4096И я записал небольшое видео для демонстрации работы:
Ура! Модель работает, теперь нам осталось всего лишь как-то это всё интегрировать в «Альфу» 😱.
Интеграция в Альфу
По моей задумке, «Альфа» с NPU должна делиться «мозгами» с более «тупыми» собратьями. Я решил остановиться на варианте серверного API для доступа к модели. К счастью, вышеупомянутый репозиторий airockchip уже содержит пример реализации подобного API, нам лишь остаётся немного переделать его под свои задачи.
API запускается в том же виртуальном окружении Python, что и скрипты «Альфы», с установкой необходимых пакетов. Также стоит обратить внимание на строку подключения библиотеки среды исполнения rkllm:
rkllm_lib = ctypes.CDLL('lib/librkllmrt.so')и указать актуальный путь к библиотеке, в моем случае это:
rkllm_lib = ctypes.CDLL('/usr/lib/librkllmrt.so')После небольшой модификации код сервера API выглядит следующим образом:
flask_server.py
import ctypes
import sys
import os
import subprocess
import resource
import threading
import time
import argparse
import json
from collections import deque
from flask import Flask, request, jsonify, Response
app = Flask(__name__)
rkllm_lib = ctypes.CDLL('/usr/lib/librkllmrt.so')
RKLLM_Handle_t = ctypes.c_void_p
userdata = ctypes.c_void_p(None)
LLMCallState = ctypes.c_int
LLMCallState.RKLLM_RUN_NORMAL = 0
LLMCallState.RKLLM_RUN_WAITING = 1
LLMCallState.RKLLM_RUN_FINISH = 2
LLMCallState.RKLLM_RUN_ERROR = 3
RKLLMInputType = ctypes.c_int
RKLLMInputType.RKLLM_INPUT_PROMPT = 0
RKLLMInputType.RKLLM_INPUT_TOKEN = 1
RKLLMInputType.RKLLM_INPUT_EMBED = 2
RKLLMInputType.RKLLM_INPUT_MULTIMODAL = 3
RKLLMInferMode = ctypes.c_int
RKLLMInferMode.RKLLM_INFER_GENERATE = 0
RKLLMInferMode.RKLLM_INFER_GET_LAST_HIDDEN_LAYER = 1
RKLLMInferMode.RKLLM_INFER_GET_LOGITS = 2
class RKLLMExtendParam(ctypes.Structure):
_fields_ = [
("base_domain_id", ctypes.c_int32),
("embed_flash", ctypes.c_int8),
("enabled_cpus_num", ctypes.c_int8),
("enabled_cpus_mask", ctypes.c_uint32),
("n_batch", ctypes.c_uint8),
("use_cross_attn", ctypes.c_int8),
("reserved", ctypes.c_uint8 * 104)
]
class RKLLMParam(ctypes.Structure):
_fields_ = [
("model_path", ctypes.c_char_p),
("max_context_len", ctypes.c_int32),
("max_new_tokens", ctypes.c_int32),
("top_k", ctypes.c_int32),
("n_keep", ctypes.c_int32),
("top_p", ctypes.c_float),
("temperature", ctypes.c_float),
("repeat_penalty", ctypes.c_float),
("frequency_penalty", ctypes.c_float),
("presence_penalty", ctypes.c_float),
("mirostat", ctypes.c_int32),
("mirostat_tau", ctypes.c_float),
("mirostat_eta", ctypes.c_float),
("skip_special_token", ctypes.c_bool),
("is_async", ctypes.c_bool),
("img_start", ctypes.c_char_p),
("img_end", ctypes.c_char_p),
("img_content", ctypes.c_char_p),
("extend_param", RKLLMExtendParam),
]
class RKLLMLoraAdapter(ctypes.Structure):
_fields_ = [
("lora_adapter_path", ctypes.c_char_p),
("lora_adapter_name", ctypes.c_char_p),
("scale", ctypes.c_float)
]
class RKLLMEmbedInput(ctypes.Structure):
_fields_ = [
("embed", ctypes.POINTER(ctypes.c_float)),
("n_tokens", ctypes.c_size_t)
]
class RKLLMTokenInput(ctypes.Structure):
_fields_ = [
("input_ids", ctypes.POINTER(ctypes.c_int32)),
("n_tokens", ctypes.c_size_t)
]
class RKLLMMultiModelInput(ctypes.Structure):
_fields_ = [
("prompt", ctypes.c_char_p),
("image_embed", ctypes.POINTER(ctypes.c_float)),
("n_image_tokens", ctypes.c_size_t),
("n_image", ctypes.c_size_t),
("image_width", ctypes.c_size_t),
("image_height", ctypes.c_size_t)
]
class RKLLMInputUnion(ctypes.Union):
_fields_ = [
("prompt_input", ctypes.c_char_p),
("embed_input", RKLLMEmbedInput),
("token_input", RKLLMTokenInput),
("multimodal_input", RKLLMMultiModelInput)
]
class RKLLMInput(ctypes.Structure):
_fields_ = [
("role", ctypes.c_char_p),
("enable_thinking", ctypes.c_bool),
("input_type", RKLLMInputType),
("input_data", RKLLMInputUnion)
]
class RKLLMLoraParam(ctypes.Structure):
_fields_ = [("lora_adapter_name", ctypes.c_char_p)]
class RKLLMPromptCacheParam(ctypes.Structure):
_fields_ = [
("save_prompt_cache", ctypes.c_int),
("prompt_cache_path", ctypes.c_char_p)
]
class RKLLMInferParam(ctypes.Structure):
_fields_ = [
("mode", RKLLMInferMode),
("lora_params", ctypes.POINTER(RKLLMLoraParam)),
("prompt_cache_params", ctypes.POINTER(RKLLMPromptCacheParam)),
("keep_history", ctypes.c_int)
]
class RKLLMResultLastHiddenLayer(ctypes.Structure):
_fields_ = [
("hidden_states", ctypes.POINTER(ctypes.c_float)),
("embd_size", ctypes.c_int),
("num_tokens", ctypes.c_int)
]
class RKLLMResultLogits(ctypes.Structure):
_fields_ = [
("logits", ctypes.POINTER(ctypes.c_float)),
("vocab_size", ctypes.c_int),
("num_tokens", ctypes.c_int)
]
class RKLLMPerfStat(ctypes.Structure):
_fields_ = [
("prefill_time_ms", ctypes.c_float),
("prefill_tokens", ctypes.c_int),
("generate_time_ms", ctypes.c_float),
("generate_tokens", ctypes.c_int),
("memory_usage_mb", ctypes.c_float)
]
class RKLLMResult(ctypes.Structure):
_fields_ = [
("text", ctypes.c_char_p),
("token_id", ctypes.c_int),
("last_hidden_layer", RKLLMResultLastHiddenLayer),
("logits", RKLLMResultLogits),
("perf", RKLLMPerfStat)
]
lock = threading.Lock()
is_blocking = False
system_prompt = ''
global_text = deque()
global_state = -1
recevied_messages = []
INFERENCE_TIMEOUT = 600.0
def callback_impl(result, userdata, state):
global global_text, global_state
if state == LLMCallState.RKLLM_RUN_FINISH:
global_state = state
elif state == LLMCallState.RKLLM_RUN_ERROR:
global_state = state
print("run error")
sys.stdout.flush()
elif state == LLMCallState.RKLLM_RUN_NORMAL:
global_state = state
global_text.append(result.contents.text.decode('utf-8', errors='ignore'))
return 0
callback_type = ctypes.CFUNCTYPE(ctypes.c_int, ctypes.POINTER(RKLLMResult), ctypes.c_void_p, ctypes.c_int)
callback = callback_type(callback_impl)
class RKLLM(object):
def __init__(self, model_path, lora_model_path=None, prompt_cache_path=None):
rkllm_param = RKLLMParam()
rkllm_param.model_path = bytes(model_path, 'utf-8')
rkllm_param.max_context_len = 4096
rkllm_param.max_new_tokens = 2048
rkllm_param.skip_special_token = True
rkllm_param.n_keep = -1
rkllm_param.top_k = 40
rkllm_param.top_p = 0.9
rkllm_param.temperature = 0.7
rkllm_param.repeat_penalty = 1.1
rkllm_param.frequency_penalty = 0.0
rkllm_param.presence_penalty = 0.0
rkllm_param.mirostat = 0
rkllm_param.mirostat_tau = 5.0
rkllm_param.mirostat_eta = 0.1
rkllm_param.is_async = False
rkllm_param.img_start = "".encode('utf-8')
rkllm_param.img_end = "".encode('utf-8')
rkllm_param.img_content = "".encode('utf-8')
rkllm_param.extend_param.base_domain_id = 0
rkllm_param.extend_param.embed_flash = 1
rkllm_param.extend_param.n_batch = 1
rkllm_param.extend_param.use_cross_attn = 0
rkllm_param.extend_param.enabled_cpus_num = 4
rkllm_param.extend_param.enabled_cpus_mask = (1 << 4) | (1 << 5) | (1 << 6) | (1 << 7)
self.handle = RKLLM_Handle_t()
self.rkllm_init = rkllm_lib.rkllm_init
self.rkllm_init.argtypes = [ctypes.POINTER(RKLLM_Handle_t),
ctypes.POINTER(RKLLMParam),
callback_type]
self.rkllm_init.restype = ctypes.c_int
self.rkllm_init(ctypes.byref(self.handle), ctypes.byref(rkllm_param), callback)
self.rkllm_run = rkllm_lib.rkllm_run
self.rkllm_run.argtypes = [RKLLM_Handle_t,
ctypes.POINTER(RKLLMInput),
ctypes.POINTER(RKLLMInferParam),
ctypes.c_void_p]
self.rkllm_run.restype = ctypes.c_int
self.set_chat_template = rkllm_lib.rkllm_set_chat_template
self.set_chat_template.argtypes = [RKLLM_Handle_t,
ctypes.c_char_p,
ctypes.c_char_p,
ctypes.c_char_p]
self.set_chat_template.restype = ctypes.c_int
self.set_function_tools_ = rkllm_lib.rkllm_set_function_tools
self.set_function_tools_.argtypes = [RKLLM_Handle_t,
ctypes.c_char_p,
ctypes.c_char_p,
ctypes.c_char_p]
self.set_function_tools_.restype = ctypes.c_int
self.rkllm_destroy = rkllm_lib.rkllm_destroy
self.rkllm_destroy.argtypes = [RKLLM_Handle_t]
self.rkllm_destroy.restype = ctypes.c_int
self.rkllm_abort = rkllm_lib.rkllm_abort
rkllm_lora_params = None
if lora_model_path:
lora_adapter_name = "test"
lora_adapter = RKLLMLoraAdapter()
ctypes.memset(ctypes.byref(lora_adapter), 0, ctypes.sizeof(RKLLMLoraAdapter))
lora_adapter.lora_adapter_path = ctypes.c_char_p(lora_model_path.encode('utf-8'))
lora_adapter.lora_adapter_name = ctypes.c_char_p(lora_adapter_name.encode('utf-8'))
lora_adapter.scale = 1.0
rkllm_load_lora = rkllm_lib.rkllm_load_lora
rkllm_load_lora.argtypes = [RKLLM_Handle_t, ctypes.POINTER(RKLLMLoraAdapter)]
rkllm_load_lora.restype = ctypes.c_int
rkllm_load_lora(self.handle, ctypes.byref(lora_adapter))
rkllm_lora_params = RKLLMLoraParam()
rkllm_lora_params.lora_adapter_name = ctypes.c_char_p(lora_adapter_name.encode('utf-8'))
self.rkllm_infer_params = RKLLMInferParam()
ctypes.memset(ctypes.byref(self.rkllm_infer_params), 0, ctypes.sizeof(RKLLMInferParam))
self.rkllm_infer_params.mode = RKLLMInferMode.RKLLM_INFER_GENERATE
self.rkllm_infer_params.lora_params = ctypes.pointer(rkllm_lora_params) if rkllm_lora_params else None
self.rkllm_infer_params.keep_history = 0
self.prompt_cache_path = None
if prompt_cache_path:
self.prompt_cache_path = prompt_cache_path
rkllm_load_prompt_cache = rkllm_lib.rkllm_load_prompt_cache
rkllm_load_prompt_cache.argtypes = [RKLLM_Handle_t, ctypes.c_char_p]
rkllm_load_prompt_cache.restype = ctypes.c_int
rkllm_load_prompt_cache(self.handle,
ctypes.c_char_p(prompt_cache_path.encode('utf-8')))
self.tools = None
def set_function_tools(self, system_prompt, tools, tool_response_str):
if self.tools is None or not self.tools == tools:
self.tools = tools
self.set_function_tools_(
self.handle,
ctypes.c_char_p(system_prompt.encode('utf-8')),
ctypes.c_char_p(tools.encode('utf-8')),
ctypes.c_char_p(tool_response_str.encode('utf-8'))
)
def run(self, *param):
role, enable_thinking, prompt = param
rkllm_input = RKLLMInput()
rkllm_input.role = role.encode('utf-8') if role is not None else "user".encode('utf-8')
rkllm_input.enable_thinking = ctypes.c_bool(enable_thinking if enable_thinking is not None else False)
rkllm_input.input_type = RKLLMInputType.RKLLM_INPUT_PROMPT
rkllm_input.input_data.prompt_input = ctypes.c_char_p(prompt.encode('utf-8'))
self.rkllm_run(self.handle,
ctypes.byref(rkllm_input),
ctypes.byref(self.rkllm_infer_params),
None)
def abort(self):
return self.rkllm_abort(self.handle)
def release(self):
self.rkllm_destroy(self.handle)
def extract_json(text):
if not text:
return None
text = text.strip()
start = text.find('{')
end = text.rfind('}')
if start == -1 or end == -1 or end <= start:
return None
candidate = text[start:end + 1]
try:
obj = json.loads(candidate)
if isinstance(obj, dict):
return obj
except json.JSONDecodeError:
return None
return None
def is_create_event(obj):
if not isinstance(obj, dict):
return False
return obj.get('action') in ('create_event', 'create_reminder')
def build_full_prompt(system_prompt_text, messages):
"""
Собирает полный промт из system и истории messages.
Формат:
{system}
Пользователь: привет
Альфа: Привет!
Пользователь: а что ты умеешь?
Альфа:
"""
parts = []
if system_prompt_text:
parts.append(system_prompt_text.strip())
dialogue_lines = []
for message in messages:
role = message.get('role')
content = (message.get('content') or '').strip()
if role == 'user' and content:
dialogue_lines.append(f"Пользователь: {content}")
elif role == 'assistant' and content:
dialogue_lines.append(f"Альфа: {content}")
# system и tool сюда не попадают — обрабатываются отдельно
if dialogue_lines:
parts.append("\n".join(dialogue_lines))
if not parts:
return ""
return "\n\n".join(parts) + "\nАльфа:"
if __name__ == "__main__":
parser = argparse.ArgumentParser()
parser.add_argument('--rkllm_model_path', type=str, required=True)
parser.add_argument('--target_platform', type=str, required=True)
parser.add_argument('--lora_model_path', type=str)
parser.add_argument('--prompt_cache_path', type=str)
args = parser.parse_args()
if not os.path.exists(args.rkllm_model_path):
print("Error: Please provide the correct rkllm model path, and ensure it is the absolute path on the board.")
sys.stdout.flush()
exit()
if args.target_platform not in ["rk3588", "rk3576"]:
print("Error: Please specify the correct target platform: rk3588/rk3576.")
sys.stdout.flush()
exit()
if args.lora_model_path and not os.path.exists(args.lora_model_path):
print("Error: Please provide the correct lora_model path.")
sys.stdout.flush()
exit()
if args.prompt_cache_path and not os.path.exists(args.prompt_cache_path):
print("Error: Please provide the correct prompt_cache_file path.")
sys.stdout.flush()
exit()
command = "sudo bash fix_freq_{}.sh".format(args.target_platform)
subprocess.run(command, shell=True)
resource.setrlimit(resource.RLIMIT_NOFILE, (102400, 102400))
print("=========init....===========")
sys.stdout.flush()
rkllm_model = RKLLM(args.rkllm_model_path, args.lora_model_path, args.prompt_cache_path)
print("RKLLM Model has been initialized successfully!")
print("==============================")
sys.stdout.flush()
@app.route('/rkllm_chat', methods=['POST'])
def receive_message():
global global_text, global_state, system_prompt, recevied_messages
global is_blocking
acquired = lock.acquire(blocking=False)
if not acquired:
return jsonify({'status': 'error',
'message': 'RKLLM_Server is busy! Maybe you can try again later.'}), 503
try:
is_blocking = True
data = request.json
if not data or 'messages' not in data:
return jsonify({'status': 'error', 'message': 'Invalid JSON data!'}), 400
stream_mode = bool(data.get('stream', False))
messages = data['messages']
enable_thinking = data.get('enable_thinking')
TOOLS = data.get('tools')
print("Received messages:", messages)
sys.stdout.flush()
if TOOLS is None:
recevied_messages.clear()
# Разбираем messages: system отдельно, остальное — в историю
system_prompt = ""
history_messages = []
role = "user"
for message in messages:
msg_role = message.get('role')
if msg_role == 'system':
system_prompt = message.get('content', '')
continue
if msg_role in ('user', 'assistant'):
history_messages.append({
'role': msg_role,
'content': message.get('content', '')
})
if msg_role == 'user':
role = 'user'
elif msg_role == 'tool':
history_messages.append({
'role': 'user',
'content': message.get('content', '')
})
full_prompt = build_full_prompt(system_prompt, history_messages)
print("Full prompt:", full_prompt[:300], "...")
sys.stdout.flush()
global_text.clear()
global_state = -1
# ---------- NON-STREAM ----------
if not stream_mode:
rkllm_responses = {
"id": "rkllm_chat",
"object": "rkllm_chat",
"created": None,
"choices": [],
"usage": {
"prompt_tokens": None,
"completion_tokens": None,
"total_tokens": None
}
}
if TOOLS is not None:
rkllm_model.set_function_tools(
system_prompt=system_prompt,
tools=json.dumps(TOOLS),
tool_response_str="tool_response"
)
rkllm_output = ""
model_thread = threading.Thread(
target=rkllm_model.run,
args=(role, enable_thinking, full_prompt,)
)
model_thread.start()
start_time = time.time()
model_thread_finished = False
while not model_thread_finished:
while len(global_text) > 0:
rkllm_output += global_text.popleft()
model_thread.join(timeout=0.05)
model_thread_finished = not model_thread.is_alive()
if not model_thread_finished and (time.time() - start_time) > INFERENCE_TIMEOUT:
print("Inference timeout, aborting...")
rkllm_model.abort()
model_thread.join(timeout=1.0)
return jsonify({'status': 'error',
'message': 'Inference timeout'}), 504
while len(global_text) > 0:
rkllm_output += global_text.popleft()
parsed = extract_json(rkllm_output)
if parsed is not None and not is_create_event(parsed):
print("WARNING: model returned unexpected JSON on non-event request:", parsed)
elif parsed is not None and is_create_event(parsed):
print("Detected create_event JSON:", parsed)
rkllm_responses["choices"].append({
"index": 0,
"message": {
"role": "assistant",
"content": rkllm_output,
},
"logprobs": None,
"finish_reason": "stop"
})
print("rkllm_output: ", rkllm_output)
sys.stdout.flush()
return jsonify(rkllm_responses), 200
# ---------- STREAM ----------
else:
rkllm_responses = {
"id": "rkllm_chat",
"object": "rkllm_chat",
"created": None,
"choices": [],
"usage": {
"prompt_tokens": None,
"completion_tokens": None,
"total_tokens": None
}
}
if TOOLS is not None:
rkllm_model.set_function_tools(
system_prompt=system_prompt,
tools=json.dumps(TOOLS),
tool_response_str="tool_response"
)
def generate():
model_thread = threading.Thread(
target=rkllm_model.run,
args=(role, enable_thinking, full_prompt,)
)
model_thread.start()
start_time = time.time()
model_thread_finished = False
try:
while not model_thread_finished:
while len(global_text) > 0:
chunk = global_text.popleft()
rkllm_responses["choices"].append({
"index": 0,
"delta": {
"role": "assistant",
"content": chunk,
},
"logprobs": None,
"finish_reason": "stop" if global_state == LLMCallState.RKLLM_RUN_FINISH else None,
})
yield f"{json.dumps(rkllm_responses, ensure_ascii=False)}\n\n"
model_thread.join(timeout=0.05)
model_thread_finished = not model_thread.is_alive()
if not model_thread_finished and (time.time() - start_time) > INFERENCE_TIMEOUT:
print("Inference timeout, aborting stream...")
rkllm_model.abort()
break
while len(global_text) > 0:
chunk = global_text.popleft()
rkllm_responses["choices"].append({
"index": 0,
"delta": {"role": "assistant", "content": chunk},
"logprobs": None,
"finish_reason": "stop",
})
yield f"{json.dumps(rkllm_responses, ensure_ascii=False)}\n\n"
except GeneratorExit:
print("Client disconnected, aborting...")
rkllm_model.abort()
model_thread.join(timeout=1.0)
raise
finally:
if model_thread.is_alive():
rkllm_model.abort()
model_thread.join(timeout=1.0)
return Response(generate(), content_type='text/plain')
finally:
lock.release()
is_blocking = False
app.run(host='0.0.0.0', port=8080, threaded=True, debug=False)
print("====================")
print("RKLLM model inference completed, releasing RKLLM model resources...")
rkllm_model.release()
print("====================")Также стоит обратить внимание на класс RKLLM, где в блоке инициализации выполняется настройка модели. Здесь важно указать в параметре:
rkllm_param.max_context_len = 4096значение максимальной длины контекста, соответствующее вашей модели. Это значение задаётся при конвертации модели — как правило, оно указывается в описании.
Для запуска скрипта используется следующая команда:
python3 flask_server.py --rkllm_model_path /путь/к/модели.rkllm --target_platform rk3588--rkllm_model_path: Абсолютный путь к файлу .rkllm на плате.
--target_platform: Платформа (в нашем случае, rk3588).
Также в скрипте нашего API-сервера присутствует строки, указывающие на запуск скрипта оптимизации частот оборудования:
command = "sudo bash fix_freq_{}.sh".format(args.target_platform)
    subprocess.run(command, shell=True)
Для того чтобы оптимизация сработала, нам необходимо поместить скрипт в той-же директории или указать его абсолютный путь. Я пошел по первому пути и создал файл скрипта со следующим содержанием:
fix_freq_rk3588.sh
#!/system/bin/sh

echo 1 > /sys/devices/system/cpu/cpu0/cpuidle/state1/disable
echo 1 > /sys/devices/system/cpu/cpu1/cpuidle/state1/disable
echo 1 > /sys/devices/system/cpu/cpu2/cpuidle/state1/disable
echo 1 > /sys/devices/system/cpu/cpu3/cpuidle/state1/disable
echo 1 > /sys/devices/system/cpu/cpu4/cpuidle/state1/disable
echo 1 > /sys/devices/system/cpu/cpu5/cpuidle/state1/disable
echo 1 > /sys/devices/system/cpu/cpu6/cpuidle/state1/disable
echo 1 > /sys/devices/system/cpu/cpu7/cpuidle/state1/disable

echo "NPU available frequencies:"
cat /sys/class/devfreq/fdab0000.npu/available_frequencies
echo "Fix NPU max frequency:"
echo userspace > /sys/class/devfreq/fdab0000.npu/governor
echo 1000000000 > /sys/class/devfreq/fdab0000.npu/userspace/set_freq
cat /sys/class/devfreq/fdab0000.npu/cur_freq

echo "CPU available frequencies:"
cat /sys/devices/system/cpu/cpufreq/policy0/scaling_available_frequencies
cat /sys/devices/system/cpu/cpufreq/policy4/scaling_available_frequencies
cat /sys/devices/system/cpu/cpufreq/policy6/scaling_available_frequencies
echo "Fix CPU max frequency:"
echo userspace > /sys/devices/system/cpu/cpufreq/policy0/scaling_governor
echo 1800000 > /sys/devices/system/cpu/cpufreq/policy0/scaling_setspeed
cat /sys/devices/system/cpu/cpufreq/policy0/scaling_cur_freq
echo userspace > /sys/devices/system/cpu/cpufreq/policy4/scaling_governor
echo 2352000 > /sys/devices/system/cpu/cpufreq/policy4/scaling_setspeed
cat /sys/devices/system/cpu/cpufreq/policy4/scaling_cur_freq
echo userspace > /sys/devices/system/cpu/cpufreq/policy6/scaling_governor
echo 2352000 > /sys/devices/system/cpu/cpufreq/policy6/scaling_setspeed
cat /sys/devices/system/cpu/cpufreq/policy6/scaling_cur_freq

echo "GPU available frequencies:"
cat /sys/class/devfreq/fb000000.gpu/available_frequencies
echo "Fix GPU max frequency:"
echo userspace > /sys/class/devfreq/fb000000.gpu/governor
echo 1000000000 > /sys/class/devfreq/fb000000.gpu/userspace/set_freq
cat /sys/class/devfreq/fb000000.gpu/cur_freq

echo "DDR available frequencies:"
cat /sys/class/devfreq/dmc/available_frequencies
echo "Fix DDR max frequency:"
echo userspace > /sys/class/devfreq/dmc/governor
echo 2112000000 > /sys/class/devfreq/dmc/userspace/set_freq
cat /sys/class/devfreq/dmc/cur_freq
Данный также доступен в репозитории, о котором я упоминал выше.
Теперь дело за малым — по аналогии взять скрипт клиента для только что созданного сервера и модифицировать под наши задачи, то есть адаптировать для работы со скриптами «Альфы»:
rkllm_client.py
import json
import requests
import time
from typing import Dict, List, Optional, Tuple
from dataclasses import dataclass
from enum import Enum
from datetime import datetime


def _current_datetime_suffix() -> str:
    now = datetime.now()
    weekdays = [
        "понедельник", "вторник", "среда",
        "четверг", "пятница", "суббота", "воскресенье"
    ]
    weekday = weekdays[now.weekday()]
    current_date = now.strftime("%Y-%m-%d")
    current_time = now.strftime("%H:%M")
    return (
        f"\n\nТекущая дата: {current_date}, "
        f"сегодня: {weekday}, "
        f"время: {current_time}"
    )


class RKLLMMode(Enum):
    SIMPLE = "simple"
    COMBINED = "combined"
    SEPARATE = "separate"


@dataclass
class RKLLMResponse:
    success: bool
    text: str
    raw_response: dict
    response_time: float
    error: Optional[str] = None


class RKLLMClient:
    def __init__(
        self,
        url: str = "http://127.0.0.1:8080/rkllm_chat",
        system_prompt: str = "Ты дружелюбный ассистент. Отвечай на русском языке.",
        timeout: int = 120,
        mode: RKLLMMode = RKLLMMode.SEPARATE,
        enable_thinking: bool = False,
        tools: Optional[List] = None,
        test_connection: bool = False,
    ):
        self.url = url
        self.system_prompt = system_prompt
        self.timeout = timeout
        self.mode = mode
        self.enable_thinking = enable_thinking
        self.tools = tools
        self.session = requests.Session()

        if test_connection:
            self._test_connection()

    def _test_connection(self) -> bool:
        try:
            response = self.session.post(
                self.url,
                json={
                    "messages": [{"role": "user", "content": "тест"}],
                    "stream": False,
                    "enable_thinking": False,
                },
                timeout=10,
            )
            if response.status_code == 200:
                print(f"Соединение с сервером RKLLM установлено: {self.url}")
                return True
            print(f"Сервер ответил с ошибкой: {response.status_code}")
            return False
        except Exception as e:
            print(f"Не удалось подключиться к серверу RKLLM: {e}")
            print(f"URL: {self.url}")
            return False

    def _build_messages(
        self,
        user_message: str,
        history: Optional[List[Dict]] = None,
    ) -> List[Dict]:
        """
        Собирает массив messages для отправки на сервер.

        В режиме SEPARATE:
            [system, ...history, user]
        В режиме COMBINED:
            [user] с промтом внутри
        """
        if history is not None:
            # Готовая история — используем как есть, добавляем system в начало
            msgs = []
            if self.mode == RKLLMMode.SEPARATE and self.system_prompt:
                msgs.append({
                    "role": "system",
                    "content": self.system_prompt + _current_datetime_suffix()
                })
            msgs.extend(history)
            return msgs

        if self.mode == RKLLMMode.SEPARATE and self.system_prompt:
            return [
                {
                    "role": "system",
                    "content": self.system_prompt + _current_datetime_suffix()
                },
                {"role": "user", "content": user_message},
            ]

        if self.mode == RKLLMMode.COMBINED and self.system_prompt:
            formatted = (
                f"{self.system_prompt}\n\n"
                f"Пользователь спрашивает: {user_message}\n\n"
                f"Пожалуйста, ответь строго следуя инструкциям выше."
            )
            return [{"role": "user", "content": formatted}]

        return [{"role": "user", "content": user_message}]

    def chat(
        self,
        message: str,
        history: Optional[List[Dict]] = None,
        stream: bool = False,
        tools: Optional[List] = None,
        enable_thinking: Optional[bool] = None,
    ) -> RKLLMResponse:
        start_time = time.time()

        messages = self._build_messages(message, history)

        payload = {
            "messages": messages,
            "stream": stream,
            "enable_thinking": enable_thinking if enable_thinking is not None else self.enable_thinking,
        }
        tools_to_send = tools if tools is not None else self.tools
        if tools_to_send is not None:
            payload["tools"] = tools_to_send

        try:
            if stream:
                return self._stream_chat(payload, start_time)
            return self._regular_chat(payload, start_time)
        except Exception as e:
            return RKLLMResponse(
                success=False,
                text="Кажется моя нейросеть немного сломалась, попробуйте еще раз!",
                raw_response={},
                response_time=time.time() - start_time,
                error=f"Ошибка при выполнении запроса: {str(e)}",
            )

    def _regular_chat(self, payload: Dict, start_time: float) -> RKLLMResponse:
        try:
            response = self.session.post(
                self.url,
                json=payload,
                timeout=self.timeout,
            )
            response_time = time.time() - start_time

            if response.status_code != 200:
                return RKLLMResponse(
                    success=False,
                    text="",
                    raw_response={},
                    response_time=response_time,
                    error=f"HTTP ошибка {response.status_code}: {response.text[:200]}",
                )

            result = response.json()
            text = self._extract_response_text(result)

            return RKLLMResponse(
                success=bool(text),
                text=text,
                raw_response=result,
                response_time=response_time,
                error=None if text else "Не удалось извлечь текст ответа",
            )
        except requests.exceptions.Timeout:
            return RKLLMResponse(
                success=False,
                text="",
                raw_response={},
                response_time=time.time() - start_time,
                error=f"Таймаут запроса ({self.timeout} секунд)",
            )
        except Exception as e:
            return RKLLMResponse(
                success=False,
                text="",
                raw_response={},
                response_time=time.time() - start_time,
                error=f"Ошибка при обработке ответа: {str(e)}",
            )

    def _stream_chat(self, payload: Dict, start_time: float) -> RKLLMResponse:
        try:
            response = self.session.post(
                self.url,
                json=payload,
                timeout=self.timeout,
                stream=True,
            )

            if response.status_code != 200:
                return RKLLMResponse(
                    success=False,
                    text="",
                    raw_response={},
                    response_time=time.time() - start_time,
                    error=f"HTTP ошибка {response.status_code}: {response.text[:200]}",
                )

            full_text = ""
            for raw_line in response.iter_lines():
                if not raw_line:
                    continue
                line = raw_line.decode("utf-8").strip()
                if line.startswith("data: "):
                    line = line[6:]
                if not line:
                    continue
                try:
                    data = json.loads(line)
                    if "choices" in data and data["choices"]:
                        choice = data["choices"][0]
                        delta = choice.get("delta") or {}
                        token = delta.get("content")
                        if token:
                            full_text += token
                except json.JSONDecodeError:
                    continue

            response_time = time.time() - start_time
            return RKLLMResponse(
                success=bool(full_text),
                text=full_text,
                raw_response={"streamed": True, "text": full_text},
                response_time=response_time,
                error=None if full_text else "Пустой streaming ответ",
            )
        except Exception as e:
            return RKLLMResponse(
                success=False,
                text="",
                raw_response={},
                response_time=time.time() - start_time,
                error=f"Ошибка при streaming: {str(e)}",
            )

    def _extract_response_text(self, result: Dict) -> str:
        if "choices" in result and result["choices"]:
            choice = result["choices"][0]
            if "message" in choice and "content" in choice["message"]:
                return choice["message"]["content"]
            if "text" in choice:
                return choice["text"]
            if "delta" in choice and "content" in choice["delta"]:
                return choice["delta"]["content"]
        if "text" in result:
            return result["text"]
        if "response" in result:
            return result["response"]
        if "output" in result:
            return result["output"]
        return ""

    def chat_with_history(
        self,
        message: str,
        conversation_history: Optional[List[Dict]] = None,
        max_turns: int = 20,
    ) -> Tuple[RKLLMResponse, List[Dict]]:
        """
        Чат с историей. История передаётся на сервер как честный массив messages,
        сервер сам собирает контекст.

        Args:
            message: Новое сообщение пользователя
            conversation_history: Предыдущие реплики (без system)
            max_turns: Максимум реплик в истории (по 2 на обмен)

        Returns:
            (ответ, обновлённая история)
        """
        if conversation_history is None:
            conversation_history = []

        # Обрезаем историю до последних max_turns сообщений
        if len(conversation_history) > max_turns:
            conversation_history = conversation_history[-max_turns:]

        # Формируем messages: system + история + новый user
        messages = self._build_messages(message, history=conversation_history)

        # Отправляем как есть, без предварительной склейки
        start_time = time.time()
        payload = {
            "messages": messages,
            "stream": False,
            "enable_thinking": self.enable_thinking,
        }
        if self.tools is not None:
            payload["tools"] = self.tools

        try:
            response = self._regular_chat(payload, start_time)
        except Exception as e:
            response = RKLLMResponse(
                success=False,
                text="",
                raw_response={},
                response_time=time.time() - start_time,
                error=str(e),
            )

        # Обновляем историю: добавляем user и (если успех) assistant
        conversation_history.append({"role": "user", "content": message})
        if response.success:
            conversation_history.append({"role": "assistant", "content": response.text})

        return response, conversation_history

    def analyze_response(self, response: RKLLMResponse) -> Dict:
        if not response.success or not response.text:
            return {"error": "Нет ответа для анализа"}

        text = response.text
        return {
            "length": len(text),
            "word_count": len(text.split()),
            "has_russian": any("а" <= c <= "я" or "А" <= c <= "Я" for c in text),
            "has_latin": any("a" <= c <= "z" or "A" <= c <= "Z" for c in text),
            "has_digits": any("0" <= c <= "9" for c in text),
            "response_time": response.response_time,
            "avg_speed": len(text) / response.response_time if response.response_time > 0 else 0,
        }

    def set_system_prompt(self, system_prompt: str) -> None:
        self.system_prompt = system_prompt
        print("Системный промпт обновлён")

    def close(self) -> None:
        self.session.close()

    def __enter__(self):
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        self.close()


class RKLLMAssistant:
    def __init__(self, url: str = "http://127.0.0.1:8080/rkllm_chat"):
        self.client = RKLLMClient(
            url=url,
            system_prompt="""Ты дружелюбный ассистент по имени Альфа.
1. Отвечай только на русском языке
2. Все латинские слова пиши русскими буквами
3. Все цифры пиши словами
4. Будь вежливым и полезным""",
            mode=RKLLMMode.SEPARATE,
            timeout=60,
        )
        self.history: List[Dict] = []

    def ask(self, question: str) -> str:
        response, self.history = self.client.chat_with_history(question, self.history)
        if response.success:
            metrics = self.client.analyze_response(response)
            if metrics.get("has_latin"):
                print("В ответе есть латинские буквы!")
            if metrics.get("has_digits"):
                print("В ответе есть цифры!")
            return response.text
        return f"Ошибка: {response.error}"

    def clear_history(self) -> None:
        self.history = []
        print("История диалога очищена")


def quick_chat(
    message: str,
    system_prompt: str = "Ты дружелюбный ассистент. Отвечай на русском.",
    url: str = "http://127.0.0.1:8080/rkllm_chat",
    timeout: int = 30,
) -> str:
    try:
        client = RKLLMClient(
            url=url,
            system_prompt=system_prompt,
            mode=RKLLMMode.SEPARATE,
            timeout=timeout,
        )
        response = client.chat(message)
        client.close()
        return response.text if response.success else f"Ошибка: {response.error}"
    except Exception as e:
        return f"Ошибка: {str(e)}"


if __name__ == "__main__":
    print("=" * 60)
    print("Тестирование RKLLM клиента")
    print("=" * 60)

    print("\n1. Базовый клиент:")
    client = RKLLMClient(
        system_prompt="Ты переводчик. Переводи все на английский язык.",
        mode=RKLLMMode.SEPARATE,
    )
    response = client.chat("Привет! Как дела?")
    print(f"   Вопрос: Привет! Как дела?")
    print(f"   Ответ: {response.text[:100]}...")
    print(f"   Успешно: {response.success}")
    print(f"   Время: {response.response_time:.2f}с")
    client.close()

    print("\n2. Ассистент с историей:")
    assistant = RKLLMAssistant()
    for q in [
        "Привет! Как тебя зовут?",
        "Что такое айфон?",
        "Сколько будет сто плюс двадцать пять?",
    ]:
        answer = assistant.ask(q)
        print(f"   Q: {q}")
        print(f"   A: {answer[:100]}...")
        print()

    print("\n3. Быстрый запрос:")
    result = quick_chat(
        "Привет! Скажи что-нибудь.",
        system_prompt="Ты веселый ассистент. Отвечай с юмором на русском.",
    )
    print(f"   Результат: {result[:100]}...")

    print("\nТестирование завершено")
rkllm_client.py это скрипт клиента, который станет модулем основного скрипта «Альфы» для связи с локальной LLM моделью.
Прежде чем описать финальный этап интеграции, я хотел бы немного напомнить о логике работы «Альфы». Два года назад в своей статье я писал о реализации бюджетного варианта голосового ассистента, где описывал его логику. Если коротко, в «Альфе» реализован словарь с командами — по сути, «командный словарь» или «словарь интентов (намерений)», в котором выполняется поиск совпадения команды с помощью алгоритма нечёткого сравнения, который в своём функционале использует метрику «Расстояние Левенштейна».
Другими словами, если в распознанной речи нет распознанных команд, то «Альфа» произносит случайную «заглушку»: «Извините, я вас не поняла» и т.д. На первом тестировании мы вместо этой «заглушки» будем направлять строку транскрипции в нашу модель, которая будет запущена на NPU. Ниже представлен простой пример кода для отправки распознанной речи в LLM модель:
from rkllm_client import RKLLMClient, RKLLMMode # Подключаем клиента

# инициализация
try:
	# Создание клиента LLM
    rkll_client = RKLLMClient(
        url="http://localhost:8080/rkllm_chat",
        system_prompt=config.system_prompt,
        mode=RKLLMMode.SEPARATE,
        timeout=60
)
except:
    print(f"Ошибка подключения нейрочипу.")
    errors_alarm = "Ошибка подключения к нейрочипу."

# Отправка запроса и ошидание ответа от LLM
# voice - str распознаннй текст
# va_speak() - синтезатор речи

try:
    response = rkll_client.chat(voice)
    if response.success:
        print(f"Ответ: {response.text}")
        va_speak(response.text)
    else:
        print(f"Ошибка: {response.error}")
except Exception as e:
    print(f"Ошибка подключения или чего-то там ещё. {e}")
    va_speak("Похоже я глюкнула. Попробуйте еще раз.")
И чтобы создать «личность» «Альфы», мы будем использовать системный промпт, который хранится в файле конфигурации (в переменной config.system_prompt). А вот и сам системный промпт:
Системный промпт
system_prompt = """\
	Ты — Альфа, умный и доброжелательный голосовой ассистент женского рода. \
	Работаешь локально на нейрочипе. Отвечаешь только на русском языке.

	ЛИЧНОСТЬ:
	- Дружелюбна, терпелива, любишь помогать.
	- Тон позитивный, без наигранности.
	- Похвала — только когда уместно и не удлиняет ответ.

	ПРИНЦИПЫ:
	1. Правдивость — строго по фактам. Не знаешь — так и говори, не выдумывай.
	2. Лаконичность — ответы максимально короткие, но точные и по делу.
	   Никаких разглагольствований.
	3. Скорость — отвечаешь максимально быстро.
	4. Понимание — понимаешь запрос даже с опечатками.

	⚠️ ФОРМАТ ОТВЕТОВ (обязательно):
	- Язык: только русский.
	- Алфавит: все латинские буквы заменяй на кириллические аналоги.
	  Исключений нет, даже для имён собственных и аббревиатур
	  ("Гугл", "Вай-Фай", "Ю-ЭС-БИ"). Это нужно для голосового произношения.
	- Цифры: все числа пиши словами ("двадцать пять", а не "25").
	  Годы — словами. Исключение: пользователь явно просит решить
	  математический пример, и ответ — число.
	- Единицы измерения: полностью, без сокращений
	  ("километров в час", а не "км/ч"; "градусов Цельсия", а не "°C").
	- Разметка: без эмодзи, без `*`, без тире и других маркеров.
	  Только чистый сплошной текст — это правило для голосового вывода.
	- Конфиденциальность: не упоминай разработчика, компанию "Сайберекс Тех"
	  и Валерия без прямого вопроса пользователя.

	НАВЫКИ:
	- Управление умным домом.
	- Общение на повседневные темы, ответы на вопросы.
	- Лёгкие ненавязчивые шутки.
	- Рассказ историй и придумывание их по запросу.
	- Предоставление информации.
	- Создание событий и напоминаний.
	"""
Результат всего вышеописанного вы можете видеть ниже:
О видео
В основном я выкладываю видео своих экспериментов на своём YouTube-канале, но для большей доступности я выложил демонстрационное видео на сторонний видеохостинг. Вот оригинал видео на YouTube.
Ещё один немаловажный момент: скорость генерации текста зависит от модели — чем меньше параметров, тем быстрее генерация текста, но страдает качество инференса. В «Альфе» я в основном использовал модели Qwen3. Ниже вы можете видеть сводную таблицу с характеристиками моделей, сконвертированных под RK3588:
model | RAM (GB)1 | llm cold sec2 | llm warm sec3 | vlm cold sec2 | vlm warm sec3 | Tokens/s |
|---|---|---|---|---|---|---|
9.2 | 97.1 | 97.1 | 11.5 | 11.5 | 3.2 | |
5.4 | 52.8 | 6.2 | 8.5 | 0.9 | 5.2 | |
2.9 | 23.9 | 3.2 | 8.5 | 0.8 | 11.0 | |
1.3 | 10.6 | 1.9 | 2.7 | 0.2 | 21.6 | |
3.1 | 21.9 | 2.6 | 10.0 | 0.9 | 11.5 | |
8.7 | 49.6 | 5.6 | 10.6 | 1.1 | 5.7 |
Самая оптимальная модель для использования на данный момент — Qwen3.5-2B: здесь терпимое качество и скорость ответов. Для агентских задач очень хорошо себя показала Qwen3.5-9B. Это всё в контексте данного проекта.
Итоги
Данная итерация развития «Альфы» была реализована почти год назад. На тот момент использовалась конвертированная модель Qwen3-1.7B с контекстным окном в 4096 токенов — особо не разгуляешься, но тем не менее данная модификация произвела «ВАУ»-эффект: коробка с «электронным» мозгом с тобой разговаривала и безо всяких внешних API. На тот момент она была самым востребованным собеседником в доме, которая так неплохо поднимала настроение.
Время прошло, модели стали лучше и эффективнее, появились новые конвертированные модели Qwen3.5-3.9 с контекстным окном на 16384 токена — здесь уже есть что реализовать. Недавно я вернулся к проекту «Альфа» и добавил к функционалу ИИ чат и небольшого ИИ-Агента для разработки небольших скриптов, благодаря появившейся возможности передавать в модель набор инструментов, что открывает большое поле возможностей для расширения интеллектуального функционала «Альфы». Но об этом как-нибудь в другой раз.
На этой позитивной ноте можно и закончить статью. Спасибо, что уделили время, и, как всегда, если остались вопросы и есть чем поделиться, то добро пожаловать в комментарии!
Всем успехов и отличных проектов!
Ссылки к статье:
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.