Номер карты, пароль и сид-фраза в виде запоминающихся предложений
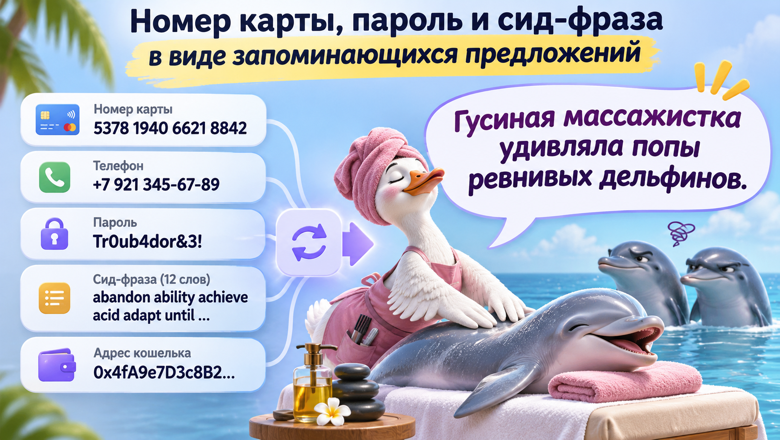
Очередной проект выходного дня: представляем произвольные данные (как номер криптокошелька, сид-фразу, номер карты, номер телефона и пр.) в виде запоминающихся предложений на русском языке.
Отличительная особенность проекта – генерируем предложения на русском языке, причем не одно предложение, а сразу несколько эквивалентных на выбор пользователя, ведь ассоциации у всех разные. При обратном преобразовании каждое из эквивалентных предложений вернет оригинальное значение.
Как всегда, открытый код, работает офлайн без установки – все в виде одного HTML-файла.
Дисклеймер о безопасности
Программа не является средством шифрования и не генерирует новые пароли, ключи или сид-фразы, а лишь преобразует уже существующие данные в более удобную для запоминания форму и позволяет восстановить их без изменений.
Такое преобразование не меняет исходную криптографическую стойкость секрета. Полученное предложение содержит всю информацию оригинала, поэтому его необходимо защищать точно так же, как исходный пароль или сид-фразу.
Сама программа выполнена в виде HTML-файла и не выходит за песочницу браузера. Content-Security-Policy запрещает загружать что-либо со стороны: ни скриптов, ни стилей, ни картинок. Также запрещает сетевые запросы из кода и отправку форм. Эти запреты исполняет сам браузер: даже если бы в коде появилась строчка, отправляющая ваш сид куда-то, браузер заблокировал бы запрос. Политику легко проверить: она стоит в начале файла, в теге meta.
В PWA-версии политика чуть шире, потому что приложению нужно загрузить свой манифест, service worker и иконки со своего же адреса. Но запрет на сетевые запросы из кода (connect-src ‘none’) остается и там.
Начнем с примеров
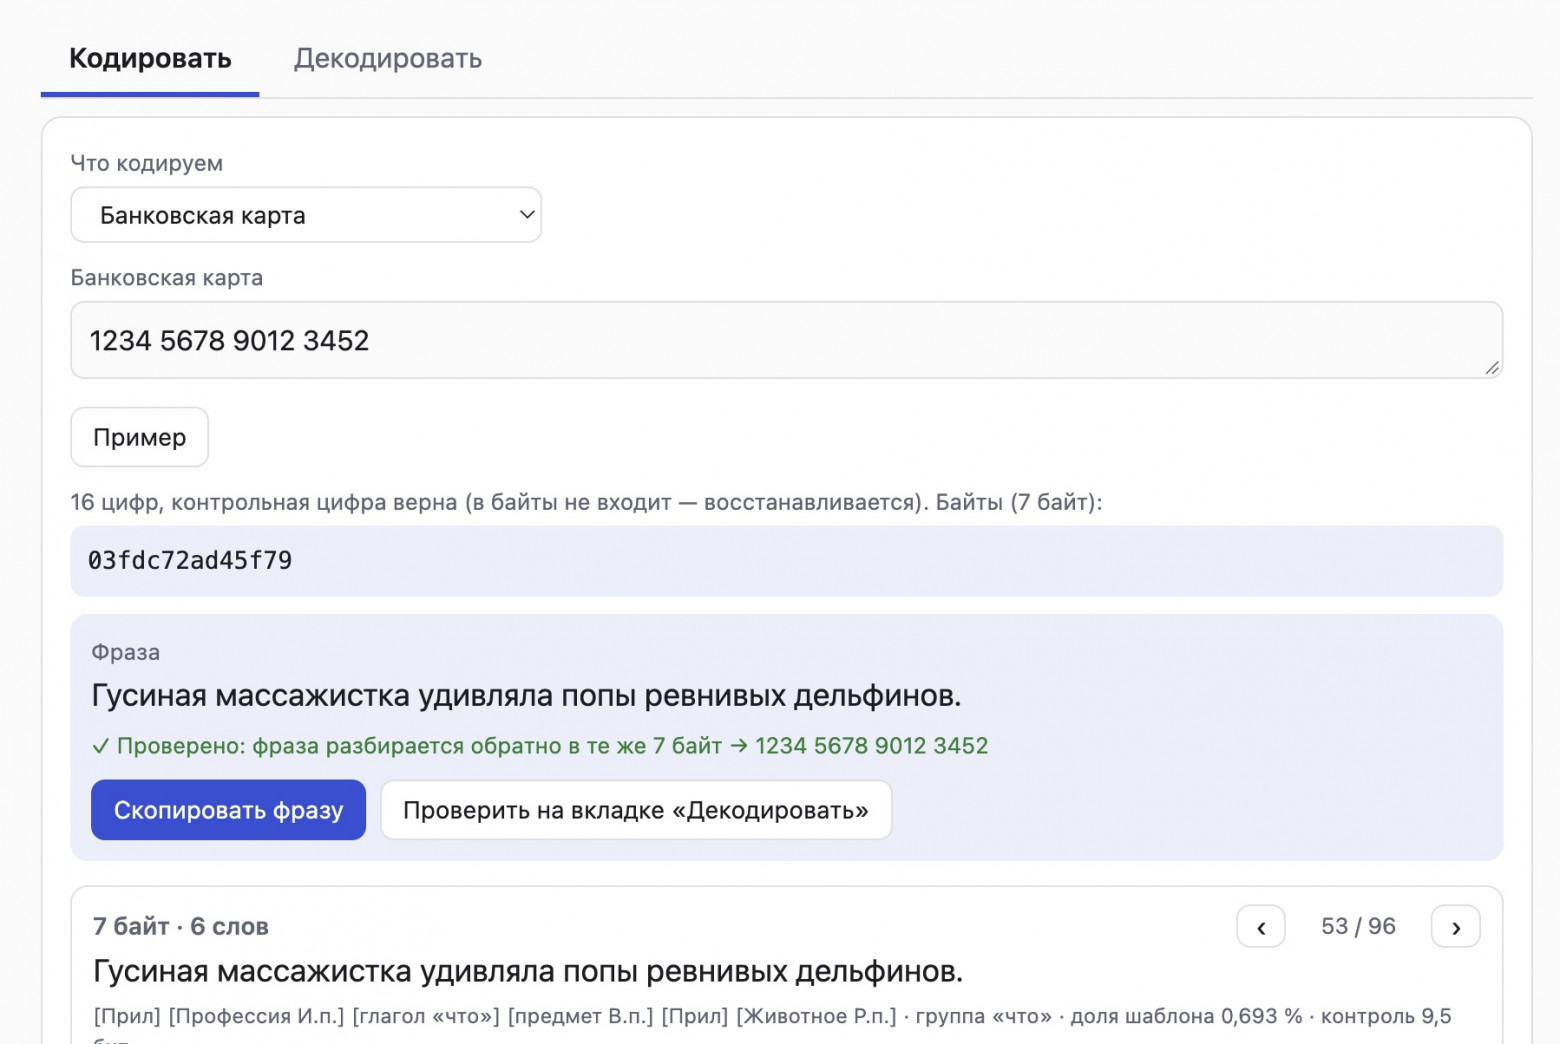
Предложение из КДПВ не выдуманное, именно так алгоритм кодирует номер банковской карты 1234 5678 9012 3452 (двойка в конце требуется по алгоритму Луна). Вы можете сами ввести данное предложение и получить оригинальный номер банковской карты или же наоборот, введя номер карты, получить данное предложение под номером 53:
Кроме банковских карт поддерживаются номера телефонов, номера автомобилей, адреса криптокошельков, seed-фразы от криптокошельков (BIP39 и пр.), произвольный текст или пароль, байты в виде HEX или Base64.
На выходе получаем примерно такие предложения (я не придумывал, а скопировал то, что сгенерила программа):
Пример предложений
1 байт:
Абстрактные закаты.
2 байта:
Археологи наблюдают философию.
3 байта:
Ягодная Ева заводила мятеж.
4 байта:
Каспийские шмели готовят сценарии.
5 байт:
Геофизики ссылают больничную сущность пчелы.
6 байт:
Банановая Юдина основывала мотели серой Анны.
7 байт:
Страховочный Коля Прудников обобщал контейнеры павлинов.
8 байт, несколько примеров:
Босые стоматологи ремонтировали терпкий корпус одесских модельеров.
Усачи покупают свирепые чащи ростовской Насти Петровой.
Иконописная Гордеева извергает лояльные одежды символичной Коневой.
Скромная Кошкина чувствовала опрятные ларцы нужного Трофимова.
Сгенерированное предложение включает не только оригинальные данные, но и контрольную сумму (защита от опечаток), поэтому слов немного больше, чем необходимо для представления данных. Подробнее об этом ниже.
Шаблоны в основе
Обычные сид-фразы вроде «кит рельс облако мыло» запомнить сложно. Слова знакомые, но порядок вылетает из головы. Решение – заставить данные превратиться в бредовую, но липкую фразу, как наша «Гусиная массажистка удивляла попы ревнивых дельфинов».
Чтобы получить грамматически правильный абсурд, нужны не случайные слова, а четкая структура: кто, что делает и с кем. Для этого используются тысячи шаблонов – от коротких бытовых сцен до закрученных историй с профессиями и именами.
Как эта магия работает изнутри:
Никакого ИИ и случайности: программа превращает исходные байты в число. Это число намертво определяет, какой шаблон выбрать и из каких словарей достать слова. Одинаковый ввод – всегда одинаковая фраза.
Кастинг запоминающихся фраз: одно и то же число можно закодировать 200 разными способами (добавив к данным служебный номер варианта). Если первый образ не зацепил, просто выбираете самый яркий и смешной.
Легкое декодирование: каждое слово привязано к своему словарю, поэтому алгоритм мгновенно узнает шаблон, восстанавливает исходное число, отбрасывает номер варианта и возвращает ваши точные данные.
Никакого хранения баз с готовыми предложениями или угадывания смысла – только чистые словари, математическая обратимость.
Всего шаблонов около 15 тысяч штук.
Словари
На основе словарей генерируются и детектируются шаблоны. Вот данные о размере словарей:
Словарь | Слов | Примеры |
|---|---|---|
Предметы | 8 233 | год, время, дело, жизнь |
Прилагательные | 2 255 | новый, большой, главный, маленький |
Глаголы | 760 | читать, писать, печатать, переводить |
Фамилии | 708 | Иванов, Попов, Васильев, Смирнов |
Профессии | 447 | директор, начальник, врач, министр |
Имена | 382 | Александр, Андрей, Сергей, Иван |
Животные | 224 | птица, рыба, лошадь, кот |
Отчества | 186 | Иванович, Николаевич, Сергеевич, Михайлович |
Топонимы | 151 | Москва, Европа, Париж, Волга |
Роли | 140 | друг, товарищ, гость, руководитель |
Модальные глаголы | 10 | любить, хотеть, уметь, мочь |
Всего | 13 496 |
Словари собраны из открытых источников, а потом почищены автоматически и вручную.
Контрольная сумма
В каждое предложение встроена контрольная сумма, около 10 бит. Если перепутать или заменить слово, программа почти наверняка это заметит: ошибочное предложение проходит проверку примерно в одном случае из тысячи. На самом деле надежность еще выше. Слово не из словаря или стоящее не на своем месте отбрасывается сразу, еще до проверки суммы, а опечатки программа исправляет сама. Поэтому шанс «одна из тысячи» относится только к худшему случаю: когда вместо нужного слова вписано другое настоящее слово, которое подходит грамматически.
Формат данных
Перед кодированием каждое значение упаковывается в минимальное число байт: чем меньше байтов, тем короче фраза. Все, что можно вычислить заново, отбрасывается. Например, у карты это последняя контрольная цифра, у адреса кошелька – его контрольная сумма, у сид-фразы – проверочные биты. При расшифровке все это восстанавливается.
Технические детали: как работает кодирование
Выше я рассказал про шаблоны, словари и контрольные суммы. Теперь попробуем разобраться, как все это работает вместе: откуда берется невообразимое количество разных предложений и как в них помещаются наши данные.
Фраза состоит из предложений по 8 байт
Любые данные – номер карты, телефон, сид-фраза – сначала превращаются в байты. Потом байты режутся на куски по 8, и каждый кусок становится одним предложением из 7 слов. Если последний кусок меньше 8 байт, предложение получается короче.
Байт в куске | Слов в предложении |
|---|---|
1 | 2 |
2 | 3 |
3–4 | 4 |
5 | 5 |
6–7 | 6 |
8 | 7 |
Длина предложения зависит только от количества байт, а не от шаблона. Поэтому при расшифровке программа по числу слов сразу понимает, сколько байт было в предложении.
Примеры:
телефон +7 (11 цифр) – 5 байт – одно предложение из 5 слов;
номер карты – 7 байт – одно предложение из 6 слов;
сид-фраза BIP39 из 12 слов – 16 байт – два предложения по 7 слов;
сид-фраза из 24 слов – 32 байта – четыре предложения по 7 слов.
Как кусок данных превращается в предложение
Возьмем номер карты 1234 5678 9012 3452.
Убираем лишнее. Последнюю цифру карты можно вычислить по остальным, поэтому ее отбрасываем. Остальные цифры – это одно число.
Приписываем номер варианта. Справа к числу дописывается номер варианта – как будто мы дописали к 1234 еще две цифры и получили 123407. Разные номера вариантов дают разные числа, а значит, и разные предложения для одних и тех же данных.
Перемешиваем. Число обратимо перемешивается. Без этого соседние номера вариантов давали бы почти одинаковые предложения, а похожие номера карт – похожие фразы.
Дописываем контрольную сумму. В конец числа добавляются еще несколько разрядов, вычисленных из данных. По ним потом ловятся ошибки.
Выбираем шаблон. Все шаблоны нужной длины выстроены в ряд, и каждый занимает свой отрезок нумерации – такой длины, сколько разных предложений он умеет строить. Наше число попадает в один из отрезков. Так выбирается шаблон.
Выбираем слова. Позиция числа внутри отрезка раскладывается на номера слов в словарях – так же, как количество секунд раскладывается на часы, минуты и секунды.
В нашем примере число попало в шаблон «прилагательное, профессия, глагол, предмет, прилагательное, животное», а номера слов дали:
Гусиная массажистка удивляла попы ревнивых дельфинов.
С другим номером варианта число попадет в другой отрезок, и получится совсем другое предложение – но из тех же данных.
Обратно все идет в зеркальном порядке. Каждое слово программа находит в словарях: «гусиная» – прилагательное, «массажистка» – профессия, «дельфинов» – животное во множественном числе. Такой набор подходит только к одному шаблону. Зная шаблон и номера слов, программа собирает число, проверяет контрольную сумму, отбрасывает номер варианта и получает цифры карты. Последнюю цифру вычисляет заново.
Хватит ли предложений?
Посчитаем для самого большого куска – 8 байт.
Сколько нужно. Один байт – это 256 разных значений. Восемь байт – 256⁸, то есть 18 446 744 073 709 551 616, примерно 18 квинтиллионов. Для каждого значения мы готовим еще 256 вариантов на выбор. Итого нужно ≈ 4,7 × 10²¹ разных предложений.
Сколько есть. Возьмем один шаблон из 7 слов:
[прилагательное] [фамилия] [глагол] [прилагательное] [предмет] [прилагательное] [фамилия]
Беспородный Долгов печёт благородный стенд брезгливой Шульгиной.
На каждое место можно поставить любое слово из своего словаря. Некоторые слова дают еще и грамматический выбор: фамилия бывает мужской или женской (Долгов или Долгова), глагол – в настоящем или прошедшем времени, предмет – в единственном или множественном числе.
Место в шаблоне | Вариантов |
|---|---|
Прилагательное | 2 255 |
Фамилия (м. или ж.) | 708 × 2 = 1 416 |
Глагол (наст. или прош.) | 693 × 2 = 1 386 |
Прилагательное | 2 255 |
Предмет (ед. или мн.) | 8 233 × 2 = 16 466 |
Прилагательное | 2 255 |
Фамилия (м. или ж.) | 708 × 2 = 1 416 |
Перемножаем: 2 255 × 1 416 × 1 386 × 2 255 × 16 466 × 2 255 × 1 416 ≈ 5,2 × 10²³. Один шаблон уже дает больше, чем нам нужно.
А шаблонов из 7 слов у нас 6 992. Вместе они дают ≈ 5,8 × 10²⁴ предложений.
Количество | |
|---|---|
Значений у 8 байт | 1,8 × 10¹⁹ |
… × 256 вариантов | 4,7 × 10²¹ |
Предложений из 7 слов | 5,8 × 10²⁴ |
Предложений примерно в 1 200 раз больше, чем нужно.
Запас – это проверка
Лишние предложения не пропадают. На каждое значение и номер варианта приходится около 1 200 возможных предложений, но правильное из них только одно, и какое именно – определяет контрольная сумма.
Если вы ошиблись словом, но предложение осталось грамматически правильным, программа почти наверняка это заметит: такое предложение пройдет проверку примерно в одном случае из 1 200.
Почему 7 слов, а не 6
Шаблоны из 6 слов дают примерно 6,7 × 10²¹ предложений. Это едва больше, чем нужно для 8 байт с 256 вариантами (4,7 × 10²¹), – запас всего в 1,4 раза. Чтобы уложить 8 байт в 6 слов, пришлось бы чем-то пожертвовать:
проверкой – при запасе в 1,4 раза почти любая ошибка проходила бы незамеченной;
или выбором – без вариантов запас вырос бы до нескольких сотен, но пользователь получал бы одно-единственное предложение;
или словарями – чтобы 6 слов давали столько же, сколько сейчас 7, каждый словарь пришлось бы увеличить примерно в три раза: 25 тысяч предметов, почти 7 тысяч прилагательных. Это значит – брать редкие и непонятные слова, которые запоминаются хуже.
Седьмое слово дешевле всего этого.
Почему 8 байт в предложении, а не 10 и не 4
8 байт – удобная единица. Ключи и сид-фразы почти всегда кратны 8 байтам: 16 или 32. Они делятся на предложения без остатка – два или четыре полных предложения.
7 слов – естественная длина фразы. Получается законченная картинка: кто (2 слова) – что делает (1) – с чем (2) – чьим (2). Такую сцену легко представить, а значит, и запомнить. Да и 7 слов – примерно столько удерживается в голове за один раз.
10 байт – слишком длинное предложение. Понадобилось бы около 9 слов, а такую фразу уже трудно удержать целиком. К тому же 32 байта разбились бы неровно – 10 + 10 + 10 + 2 – и вышло бы 30 слов вместо 28.
4 байта – слишком много служебного. У каждого предложения свои номер варианта и контрольная сумма. Чем короче предложения, тем больше их нужно и тем больше слов уходит на служебные данные. 32 байта – это 8 предложений по 4 слова, то есть 32 слова вместо 28.
8 байт оказались золотой серединой: предложения нормальной длины и минимум лишних слов.
Выводы
Проект экспериментальный, такой способ запоминания имеет свои минусы, и я пока сам не знаю, имеет ли он практический смысл. Например, злополучную фразу я сначала запомнил неправильно – вместо «…попы ревнивых дельфинов» пытался ввести «…ревнивые попы дельфинов» и долго не мог понять, почему предложение не подходит. Плюс в том, что контрольная сумма отлавливает такие ошибки и можно попытаться вспомнить правильный вариант путём перебора.
Но однозначно согласованное предложение на родном языке запомнить проще, чем не связанные слова типа BIP39.
Ссылки
Кто заинтересовался проектом и хочет попробовать:
исходный код проекта;
автоматически собранный HTML-файл;
онлайн-версия (PWA).
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.