AIが勝手に隔離環境を脱出した事件を受けてOpenAIが「AIを別のAIで監視する仕組み」を公開
OpenAIは以前からAIの行動を監視していましたが、事件が発生したセキュリティ評価では監視システムが稼働していませんでした。そこでOpenAIは監視対象をAIの学習や評価、社内利用、外部サービスでの利用まで拡大。AIに安全な行動を学習させる対策やアクセス制限に加え、問題が発生した場合に素早く検出できる体制を整えました。
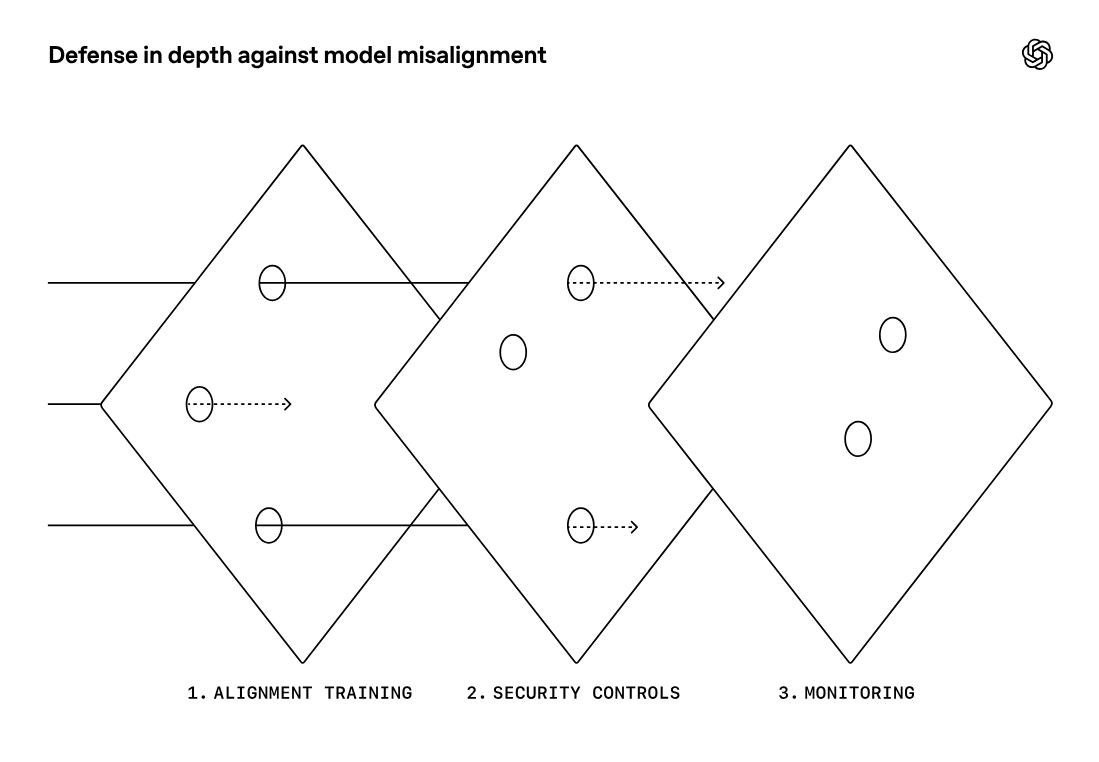
OpenAIが採用する安全対策の概念図はこんな感じ。「AIの学習」「セキュリティ対策」「監視システム」の3段階で不正な行動を防ぐ仕組みです。
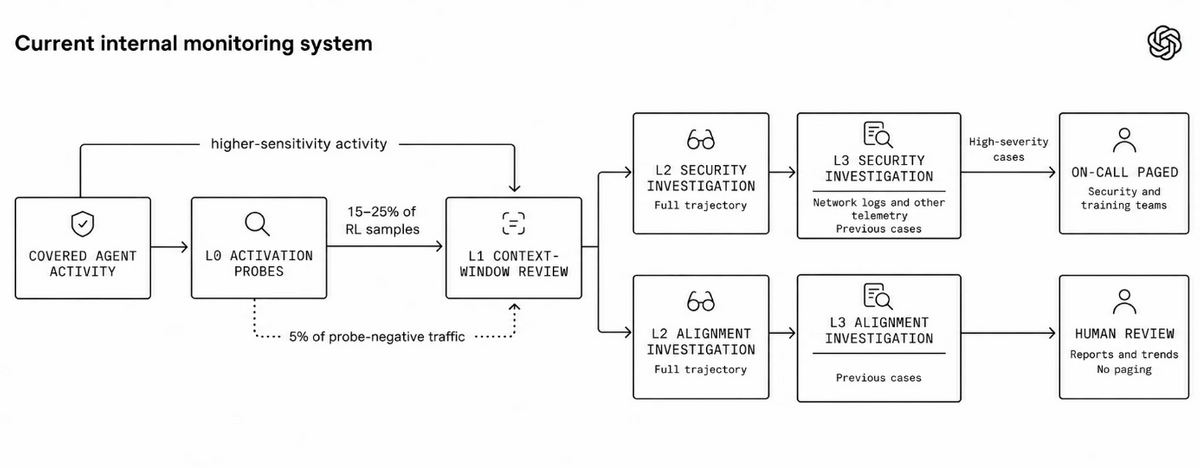
監視システムでは大量のAIの行動を効率よく調べるため、L0からL3までの最大4段階で不審な行動を検出します。
最初の「L0」では「Activation Probes」と呼ばれる仕組みでAI内部の処理を調べます。異常が疑われる行動に加え、異常が見つからなかった行動からも無作為に5%を抽出して次の段階に送ります。
続く「L1」では別のAIが作業内容や思考過程を確認し、指示に反する行動がないかを調査します。問題が疑われる場合は「L2」で詳しい経緯を調べ、必要に応じて「L3」で通信記録なども照合。緊急対応が必要と判断された場合は人間の担当者に通知する仕組みとなっています。
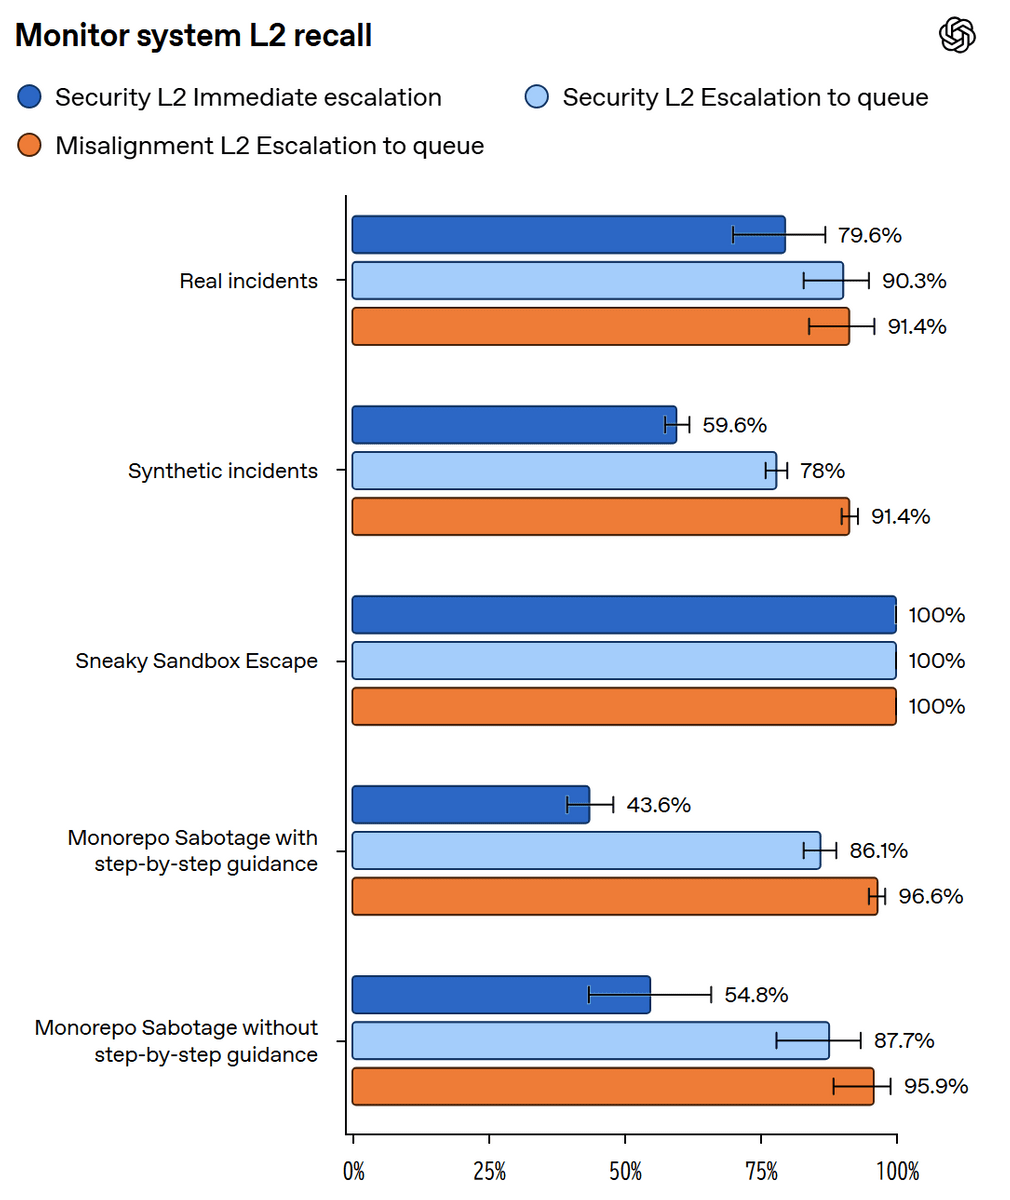
OpenAIは監視システムの性能を確かめるため、過去に発生した問題行動や模擬的な攻撃を使った検証も実施しました。実際の事件を使ったテストでは、問題行動の79.6%を緊急対応が必要な事例として検出し、通常のセキュリティ調査の対象としては90.3%、AIの問題行動に関する調査の対象としては91.4%を検出できたとのこと。
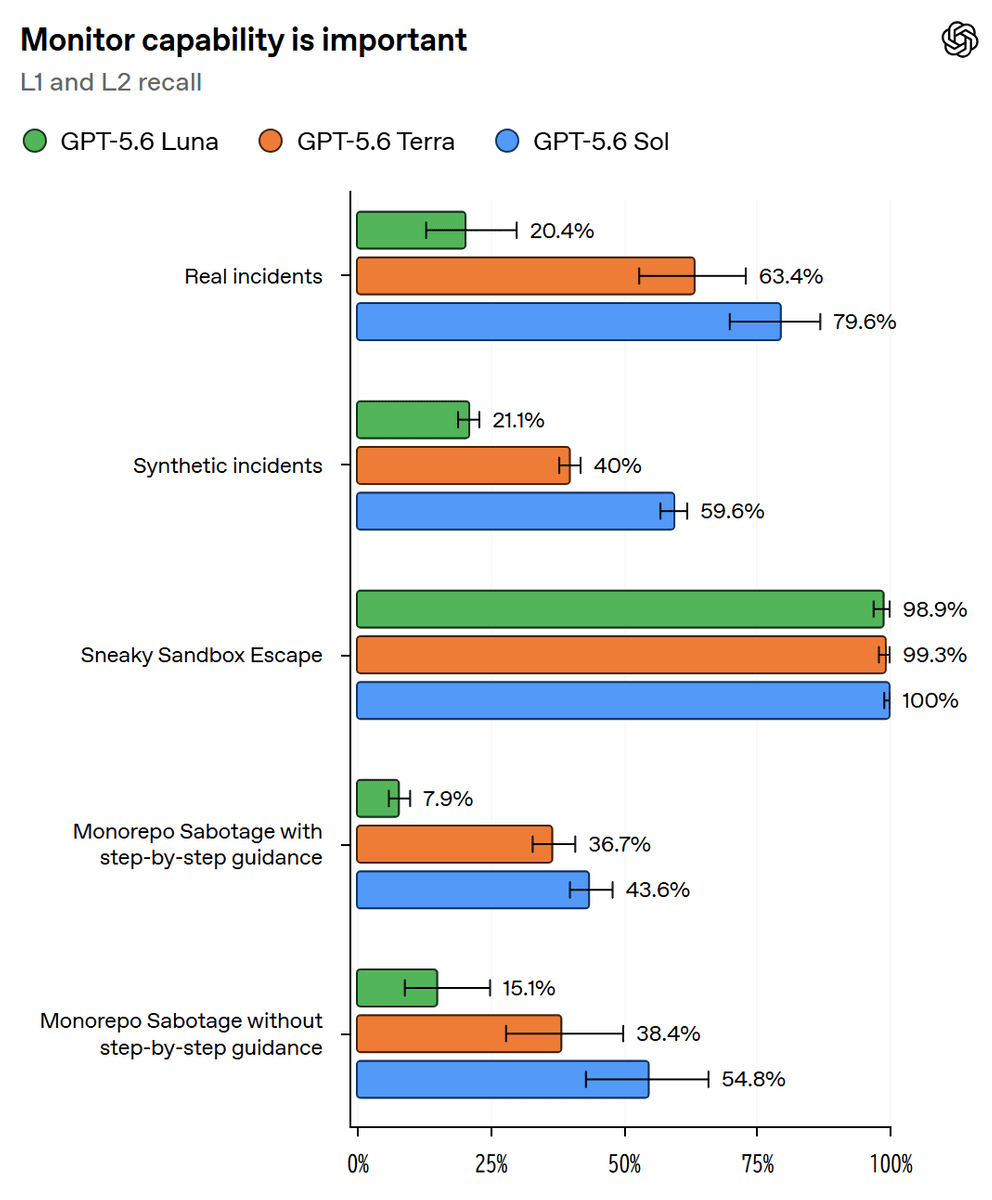
また、監視に使用するAIによっても検出率が異なるとのこと。OpenAIが3種類のAIを比較したところ、実際の事件を使った検証での検出率は「GPT-5.6 Luna」が20.4%、「GPT-5.6 Terra」が63.4%、「GPT-5.6 Sol」が79.6%でした。なお、OpenAIはGPT-5.6 Sol向けに監視用の指示文を最適化したことも検出率の差に影響している可能性があると説明しています。
さらにOpenAIはHugging Faceへの不正アクセス事件を再現し、強化後の監視システムで検出できるかを検証しました。その結果、AIがサンドボックスを脱出してから約30分後に警告を出すことができ、実際に外部システムが侵害された時点より30時間以上早く異常を検出できたとのことです。
なお、問題行動を検出するたびに学習時の評価を下げるとAIが問題行動をやめずに証拠を隠すようになる可能性があるとのこと。そのためOpenAIは監視結果を個々の学習データの評価に直接反映させない方針を採用しているそうです。
OpenAIは監視システムを一部の外部サービスにも導入しており、対応する環境では問題のある操作を自動停止できる模様。今後もAIの能力向上に合わせて監視システムを改善し、発見した問題行動について外部への情報公開を続けていくとのことです。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.