[Перевод] Как выбирать нужный ИИ
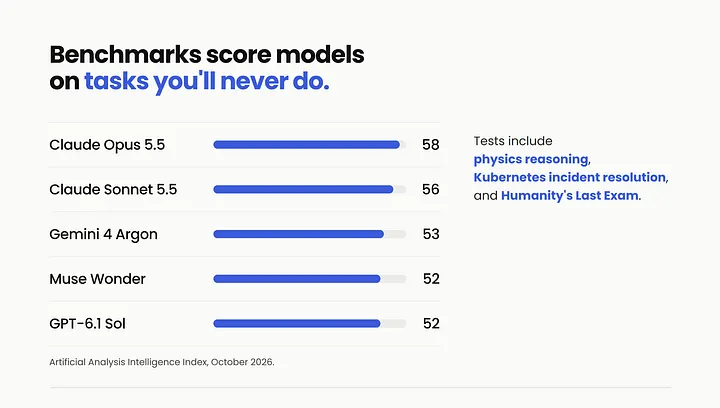
За последний месяц вышло достаточно новых передовых ИИ-моделей. Если вы уже перестали понимать, чем одна отличается от другой и какая вообще нужна именно вам, в этом нет ничего удивительного: релизы идут слишком быстро, а сравнения обычно сводятся к таблицам с результатами тестов.
Такие тесты проверяют модели на математике университетского уровня, физике, программировании и сложных задачах на рассуждение. Они хорошо показывают общий прогресс технологий, но почти не отвечают на практический вопрос: какая модель лучше напишет холодное письмо, поможет разобрать стратегию или самостоятельно доведёт рабочую задачу до результата.
Бенчмарки вроде Humanity’s Last Exam сами по себе интересны и позволяют оценивать, насколько далеко продвинулись современные модели. Но при выборе инструмента для повседневной работы полезнее начинать не с места в рейтинге, а с более простого вопроса:
"Что именно я хочу поручить ИИ?"
Три роли для ИИ
Для себя я делю задачи на три категории: партнер для обсуждения, исполнитель и проактивный агент. У каждой роли свои требования, поэтому модель, которая отлично подходит для одной задачи, может быть неудобной для другой.
1. Партнер для обсуждения
В этом режиме ИИ скорее напоминает умного коллегу. Его задача не обязательно в том, чтобы сразу выдать законченный ответ, а в том, чтобы помочь развить мысль: заметить слабое место, поспорить с предположением, предложить другой взгляд на проблему или быстро проверить идею на прочность.
Цель здесь не идеальный ответ, а более качественное мышление.
Поэтому особенно важна скорость. Во время мозгового штурма не хочется задать вопрос, уйти обедать и через десять минут возвращаться за ответом. Если обсуждение уже идет, модель должна поддерживать его темп, иначе паузы начинают мешать самому процессу мышления.
2. Исполнитель задачи
Здесь модель получает уже конкретную работу. Например, можно поручить ей свести воедино несколько часов пользовательских интервью, проанализировать большой массив данных или собрать новый сценарий адаптации пользователей в продукте.
В таком режиме требования меняются. Модель должна не просто рассуждать правильно, а с первого раза выдать результат, который уже можно использовать без обязательного дополнительного диалога. Хороший исполнитель должен довести задачу до полезного результата без постоянного контроля.
Один из самых неприятных сценариев выглядит так: через несколько часов открываешь задачу, рассчитывая увидеть ее выполненной хотя бы на 80 %, а обнаруживаешь, что агент застрял где-то в самом начале. Поэтому для таких задач самостоятельность и способность завершать работу важнее минимальной задержки первого ответа.
3. Проактивный агент
Проактивный агент находится между собеседником и исполнителем. Исполнителю вы прямо говорите, что нужно сделать, а агент может продолжать следить за ситуацией и сообщать, если что-то изменилось или появилась информация, которую вы изначально даже не собирались искать.
Например, задача может звучать так:
"Найди подходящие вакансии в стартапах с учётом моих навыков и требований к зарплате."
Хороший агент в таком случае способен найти позицию в перспективной компании, которую я сам не заметил бы на обычных досках вакансий вроде Y Combinator Jobs. Здесь особенно важна не только правильность ответа, но и способность не пропустить значимую возможность.
Качество — не единственный критерий
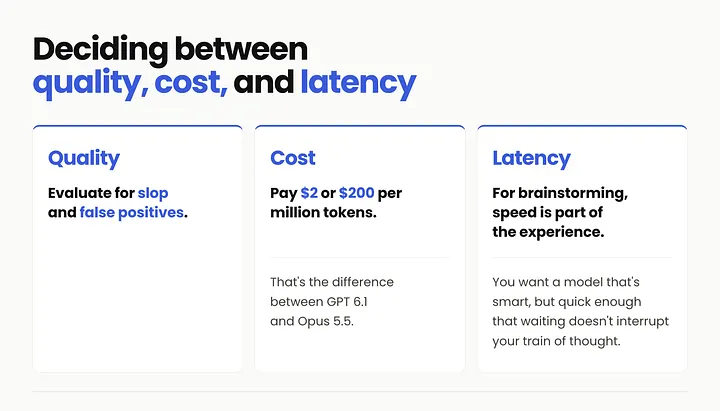
Сам ответ модели - только одна часть выбора. Я дополнительно смотрю на то, сколько времени заняла работа и сколько она стоила, потому что для разных сценариев эти параметры имеют разный вес.
Когда ИИ используется как партнер для обсуждения, критична скорость. Медленная модель ломает темп разговора и заставляет ждать там, где хочется быстро проверить очередную мысль.
Для автономной задачи сильнее начинает влиять стоимость. Агент может выбрать неудачный путь, потребовать повторного запуска или выполнить больше действий, чем ожидалось. Если каждый такой эксперимент дорогой, автономность быстро теряет смысл, потому что появляется желание снова контролировать каждый шаг.
Какие модели я выбрал
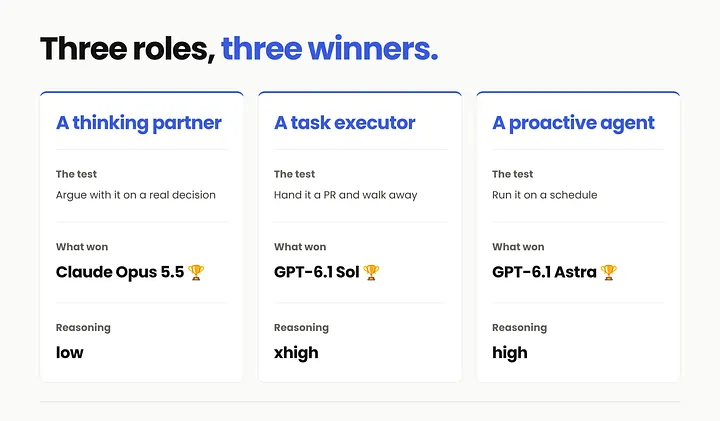
Лучший партнер для обсуждения - Claude Opus 5.5
Во время мозгового штурма мне важнее скорость, чем максимальная глубина каждого отдельного ответа, поэтому уровень рассуждения я выставляю на низкий. Модель тратит меньше времени на предварительную проработку и быстрее включается в диалог.
В таком режиме я скорее выберу быстрый ответ с небольшой неточностью, чем буду долго ждать почти идеального. Если модель промахнулась, её всегда можно поправить следующей репликой; главное, чтобы поток идей не останавливался.
Лучший исполнитель - GPT-6.1 Sol
Для автономных задач я выбрал GPT-6.1 Sol прежде всего из-за стоимости. Эта модель уже входит в подписку ChatGPT, поэтому отдельный запуск не ощущается как дополнительный расход на каждый шаг.
Когда задача выполняется без постоянного наблюдения, цена становится особенно важной. Я не контролирую каждое действие модели: иногда работу приходится запустить повторно, иногда она выбирает не самый удачный путь, а иногда делает больше, чем я ожидал.
Если такие отклонения стоят недорого, я действительно могу делегировать задачу и перестать за ней следить. С дорогой моделью быстро возникает обратный эффект: начинаешь постоянно проверять её работу, и смысл делегирования частично исчезает.
Лучший проактивный агент - GPT-6.1 Astra
Astra я использую для фоновых задач, хотя часть этого выбора, вероятно, связана с обычным страхом что-то упустить. Когда агенту поручен поиск в интернете, мне важно, чтобы он не пропустил информацию, способную изменить следующее решение.
Это может быть выгодное предложение, новый конкурент, неожиданная возможность или идея, которая заставит иначе посмотреть на продукт. В таких задачах я готов немного переплатить за модель, которой больше доверяю именно в вопросе полноты поиска и способности заметить действительно значимые изменения.
Не спешите обвинять модель
Сама модель — только один элемент всей системы. Одна и та же LLM может вести себя по-разному в Claude Code, Codex и Cursor, потому что меняются обвязка, системные инструкции, доступные инструменты, контекст и способ постановки задачи.
Из-за этого сравнение моделей оказывается сложнее, чем кажется. Можно думать, что тестируется именно LLM, хотя по факту одновременно оцениваются модель, среда запуска, инструкции и контекст; достаточно изменить один компонент, и результат той же задачи может заметно отличаться.
Как влияет уровень рассуждения
Перед формированием ответа модель выполняет некоторый объем внутренней работы. Большую часть этого процесса пользователь не видит, и в большинстве случаев наблюдать за ним напрямую нет необходимости. Если выставить высокий уровень рассуждения, модель получает больше ресурсов на предварительную проработку задачи. Для сложных вопросов это может помочь, но одновременно увеличивается задержка ответа и расход токенов.
Поэтому максимальный уровень рассуждения нет смысла автоматически включать для любой задачи. Иногда дополнительная глубина действительно улучшает результат, а иногда только делает ответ медленнее и дороже.
Для новых моделей приходится пересматривать старые инструкции
Новая модель не обязательно лучше работает с теми же инструкциями, которыми вы пользовались раньше. После выхода новой версии имеет смысл проверить формулировки, которые автоматически перекочевали из предыдущей.
Anthropic сообщала, что для Opus 5 и Fable 5 из системного промпта Claude Code убрали более 80 % содержимого без измеримого ухудшения результатов в тестах по программированию. В руководстве Anthropic описывается, как компания выбирала, какие инструкции можно удалить. Для меня это хороший повод пересмотреть привычку автоматически добавлять в каждый запрос что-нибудь вроде «обязательно перепроверь свою работу». На одной модели такая фраза действительно может помочь, а на другой просто займёт часть контекста и увеличит расход токенов, не дав заметного улучшения.
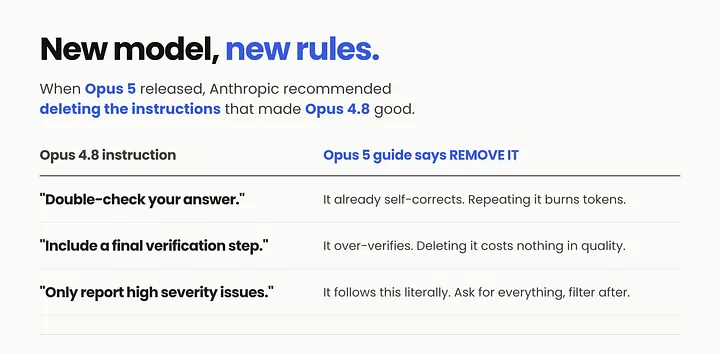
Смысл не в том, чтобы перестать проверять работу модели. Проверять нужно сами инструкции: если конкретная формулировка стабильно улучшает результат, её стоит оставить; если разницы нет, она только занимает место и увеличивает стоимость запроса.
Собственная система оценки полезнее общего рейтинга
Для разных типов своих задач я сделал отдельные наборы тестов. В них есть проверка кода, стратегический анализ и оптимизация рекламных кампаний для бизнеса.
Один из вопросов выглядел так:
"Есть 30 рекламных объявлений и ни одной продажи. Что делать дальше?"
Правильным первым шагом я считаю проверку системы отслеживания и аналитики. Нулевые продажи могут означать не только плохую рекламу: возможно, сломался сбор данных, и цифры вообще не отражают реальную ситуацию. Одна из моделей предложила просто отключить объявления из-за их низкой эффективности. Ответ звучит уверенно и на первый взгляд логично, но пропускает более фундаментальный вопрос:
"Можно ли доверять этим цифрам?"
Модель может звучать убедительно и все равно упустить главное. Поэтому важен не только выбор LLM, но и способность понять, когда ответ стоит поставить под сомнение, что именно нужно проверить и как скорректировать дальнейшую работу. Некоторые модели специально обучены чаще останавливаться и перепроверять результат. Иногда это действительно помогает, но большее количество токенов на рассуждение само по себе не гарантирует более качественного решения, поэтому оценивать нужно именно тот результат, который важен в вашей задаче.
Что в итоге
Универсально лучшей ИИ-модели для всех задач нет. Выбор начинается не с места в очередном рейтинге, а с того, какую работу нужно выполнить и какие характеристики важны именно в этом сценарии. Для интерактивного обсуждения на первый план выходит скорость. Для автономной задачи важнее способность довести работу до результата и приемлемая стоимость повторных попыток, а для проактивного агента особенно важна вероятность не пропустить информацию, способную повлиять на дальнейшие действия.
Поэтому рабочий принцип должен выглядеть так: выбрать модель под конкретную задачу, проверить её на собственных примерах, а затем сравнить качество, скорость и стоимость. И через некоторое время такой тест придется повторить, потому что к тому моменту, скорее всего, появится еще одна новая модель.
Чтобы не тратить время на ежедневный мониторинг десятков AI-релизов, я делаю это за вас: тестирую новые модели и обновления и публикую в ДругОпенсурса только то, что действительно стоит внимания. Там же короткие выводы из тестов и мои наблюдения о том, что реально полезно в работе.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.